
Dziękujemy za opinię.
 Opinia?
Powiadomienia w Control Hub to centralne miejsce do zarządzania alertami dotyczącymi wdrożenia Webex. Administratorzy mogą skonfigurować alerty, aby były dostarczane za pośrednictwem poczty e-mail, webhooków, PagerDuty lub w przestrzeni aplikacji Webex. Niezależnie od skonfigurowanego kanału dostawy, wszystkie alerty będą zawsze wyświetlane w Control Hub.
Każdy administrator ma własny zestaw alertów i reguł, które może tworzyć i wyświetlać na kartach Moje alerty i Moje reguły, a wszystkie alerty i reguły innych administratorów w organizacji mogą wyświetlać na kartach Wszystkie alerty i Wszystkie reguły.
Alerty z ostatnich 14 dni pojawią się w sekcji Alerty. Możesz wyeksportować historyczne alerty z ostatnich 30 dni w formacie CSV, klikając przycisk eksportu.
Alerty, które pojawiają się tego samego dnia i mają tę samą wagę, typ i cel, są pogrupowane w składanym menu rozwijanym, aby ułatwić przeglądanie i nawigację. Możesz najechać kursorem na przycisk rozwiń, aby zobaczyć, w jaki sposób alerty zostały połączone.
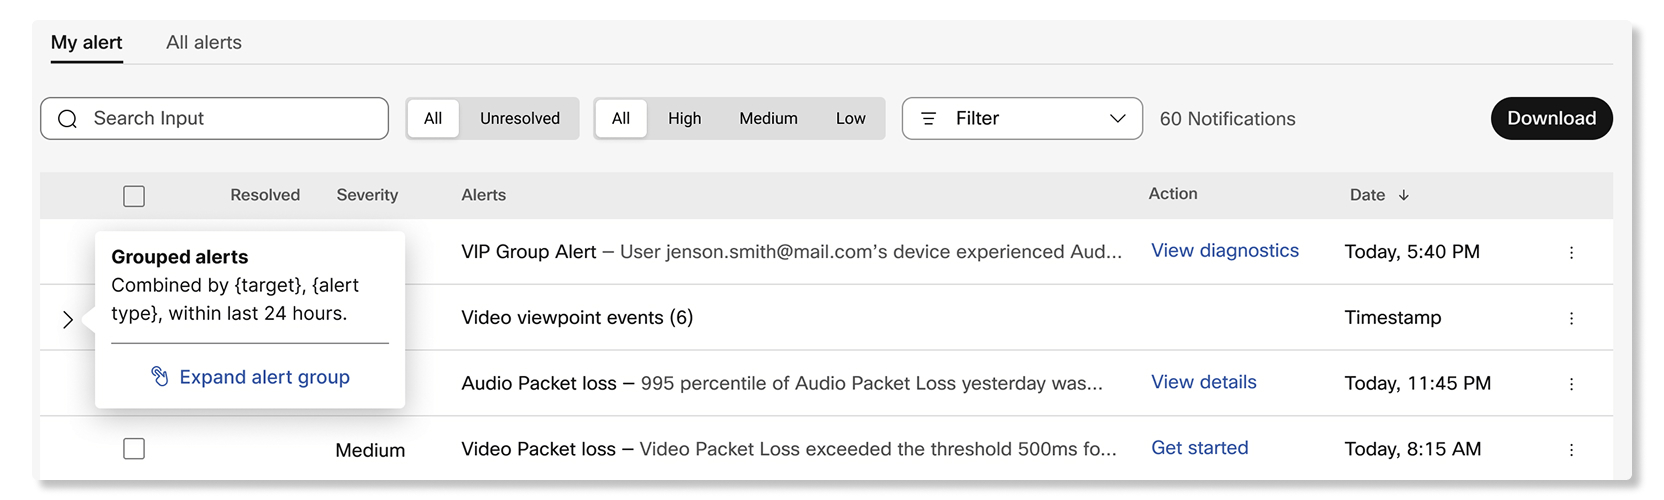
Istnieją dwie kategorie alertów: oparte na progu i generowane przez usługę.
Alerty oparte na progach
Administratorzy mogą utworzyć regułę do monitorowania określonych zdarzeń, określając określone progi, takie jak uczestnicy, którzy osiągną opóźnienie powyżej 300 ms lub utratę pakietów powyżej 8%. Te alerty są uruchamiane tylko wtedy, gdy administratorzy skonfigurują je poprzez utworzenie reguły.
Administratorzy mogą dodatkowo skonfigurować sposób dostarczania tych alertów, wybierając dla nich kanał dostawy:
- E-mail — możesz dodać do 30 adresów e-mail jako odbiorców, aby otrzymywać powiadomienia.
-
Aplikacja Webex — Alert można otrzymać w nowej przestrzeni, istniejącej
przestrzeni lub w przestrzeni 1:1.
Jeśli nazwa istniejącej przestrzeni zostanie zmieniona, alert będzie nadal dostarczany do tego samego miejsca.
- Webhook — Alerty zostaną dostarczone na adres URL webhook skonfigurowany w Control Hub.
- PagerDuty — Możesz wprowadzić klucz usługi, aby dostarczać alerty do powiązanej usługi za pomocą PagerDuty.
Alerty generowane przez usługi
Te alerty są tworzone automatycznie przez usługi Webex. Większość z tych alertów ma charakter krytyczny, na który administrator powinien zwrócić uwagę. Administratorzy mogą zarządzać sposobem dostarczania tych alertów, wybierając dla nich kanał dostarczania podobny do alertów opartych na progach. Kanały dostawy obejmują e-mail, aplikację Webex, webhook i PagerDuty.
Wyświetlanie alertów i reguł
| 1 |
Zaloguj się do Control Hub i przejdź do Powiadomienia. |
| 2 |
Wybierz jedną z następujących opcji:
|
Znajdź alerty według celu
Użyj kolumny C el, aby zobaczyć, na które urządzenie, obszar roboczy, użytkownik, punkt odniesi enia lub inny cel ma wpływ alert. Szukaj według nazwy docelowej, aby znaleźć powiązane alerty.
Cel pojawia się tylko wtedy, gdy informacje docelowe są dostępne dla alertu.
| 1 |
Zaloguj się do Control Hub i przejdź do Po . |
| 2 |
Wybierz opcję Wszystkie alerty lub Moje alerty. |
| 3 |
Sprawdź kolumnę Cel pod kątem docel owego, którego dotyczy problem. |
| 4 |
Wprowadź nazwę docelową w polu wyszukiwania, aby znaleźć pasujące alerty. |
Zrozumienie typu alertu
Przeczytaj wyjaśnienie typu alertu w panelu bocznym, aby dowiedzieć się, co oznacza alert.
Opisy nie są dostępne dla każdego typu alertu.
| 1 |
Zaloguj się do Control Hub i przejdź do Po . |
| 2 |
Wybierz Wszystkie alerty lub Moje alerty, a następnie otwórz alert. |
| 3 |
Jeśli obok Typ pojawi się ikona informacji, użyj jej do przeczytania wyjaśnienia. |
DlaWebex Meetings, możesz utworzyć reguły, aby otrzymywać alerty dla:
- Monitorowanie spotkań na żywo — Użyj tego alertu, aby dowiedzieć się, kiedy uczestnicy mają problemy z jakością mediów podczas trwających spotkań. Możesz utworzyć do 10 takich alertów.
- Monitorowanie spotkań na żywo urządzenia — Użyj tego alertu, aby dowiedzieć się, kiedy urządzenia napotykają problemy z jakością mediów podczas trwających spotkań. Możesz utworzyć do 25 takich alertów.
- Historyczny trend jakości spot kań — Użyj tego alertu, aby dowiedzieć się, kiedy procent uczestników w określonych witrynach i lokalizacjach Webex osiąga progi jakości mediów, które są ustawiane automatycznie na podstawie wyników spotkań w przeszłości w ciągu ostatnich siedmiu dni. Możesz utworzyć do 10 takich alertów.
- Monitorowanie jakości spotkań histor ycznych — Podobnie jak w przypadku ostrzeżenia o trendzie jakości spotkań historycznych, możesz użyć tego alertu, aby ustawić własne progi dotyczące tego, kiedy otrzym ywać alert, gdy procent uczestników w określonych witrynach i lokalizacjach Webex osiągnie dowolny z progów jakości mediów. Możesz utworzyć do 10 takich alertów.
Powiadomienia o spotkaniach uruchamiają się tylko dla uczestników, którzy uczestniczą w spotkani Webex Meetings ach za pośrednictwem aplikacji Webex. Minimalne wersje aplikacji, których uczestnicy muszą używać do uruchamiania alertów, to:
-
Webex Meetingsaplikacja komputerowa w wersji 39.6.5 lub nowszej
-
Webex Meetingsaplikacja mobilna na Androida i iOS w wersji 39.11 lub nowszej
-
Webex App dla komputerów stacjonarnych w wersji 3.0.12427.0 lub nowszej
-
Aplikacja Webex Mobile Android w wersji 4.1.6 lub nowszej
-
Aplikacja Webex dla urządzeń mobilnych iOS w wersji 4.3 lub nowszej
Alerty nie są uruchamiane w przypadku spotkań tylko audio, wydarzeń Webex i sesji szkoleniowych Webex.
Możesz włączyć do 10 alertów monitorowania spotkań na żywo w każdej organizacji. Każdy alert może monitorować do 30 adresów e-mail użytkowników lub 30 urządzeń.
Jeśli pole wyboru Monitoruj wszystkich uczestników jest zaznaczone, alert uruchamia się tylko w przypadku spotkań z mniej niż 50 uczestnikami.
| 1 |
Zaloguj się do Control Hub i przejdź do Po wiad omienia > Moje reguły. |
| 2 |
Kliknij opcję Utwórz regułę. |
| 3 |
Wybierz opcję Monitorowanie spotkania na żywo obok opcji Typ i wprowadź nazwę alertu obok pozycji Tytuł. |
| 4 |
Przełącz przełącznik Stan na włączony, aby otrzymywać powiadomienia o alercie. |
| 5 |
Wybierz adres e-mail użytkownika lub Nazwa (y) urządzenia i wprowadź maksymalnie 30 adresów e-mail użytkowników lub urządzeń. |
| 6 |
Zaznacz pole wyboru Monitoruj wszystkich uczestników, aby otrzymywać powiadomienia o wszystkich uczestnikach uczestniczących w tych samych spotkaniach co użytkownicy lub urządzenia z listy. |
| 7 |
W sekcji Reg uły ustaw następujące progi:
|
| 8 |
Ustaw czas trwania kumulacji i kolejności, aby wyzwalał alert. |
| 9 |
W sekcji Kanał dostawy zaznacz pole wyboru E-mail i wprowadź adresy e-mail osób, które otrzymają alerty. |
| 10 |
Zaznacz pole wyboru Przest rzeń Webex i wprowadź nazwę pomieszczenia, jeśli chcesz otrzymywać wiadomości w tej przestrzeni po osiągnięciu progu. |
| 11 |
Kliknij przycisk Zapisz. |
Możesz włączyć do 25 alertów monitorowania spotkań na żywo urządzeń w każdej organizacji.
| 1 |
Zaloguj się do Control Hub i przejdź do Po wiad omienia > Moje reguły. |
| 2 |
Kliknij opcję Utwórz regułę. |
| 3 |
Wybierz opcję Monitorowanie spotkania na żywo urządzenia obok opcji Typ i wprowadź nazwę alertu obok pozycji Tytuł. |
| 4 |
Przełącz przełącznik Włączone na włącz ony, aby otrzymywać powiadomienia o alercie. |
| 5 |
Wybierz monitorowanie:
|
| 6 |
W sekcji Reg uły ustaw następujące progi audio i wideo:
|
| 7 |
Ustaw czas trwania kumulacji i kolejności, aby wyzwalał alert. |
| 8 |
W sekcji Kanał dostawy możesz:
|
| 9 |
Kliknij przycisk Zapisz. |
Możesz dodać do 10 historycznych alertów dotyczących trendów dotyczących jakości spotkań na organizację.
| 1 |
Zaloguj się do Control Hub i przejdź do Po wiad omienia > Moje reguły. |
| 2 |
Kliknij opcję Utwórz regułę. |
| 3 |
Wybierz Historyczny trend jakości spotkania obok pozycji Typ i wprowadź nazwę alertu obok pozycji Tytuł. |
| 4 |
Przełącz przełącznik Stan na włączony, aby otrzymywać powiadomienia o alercie. |
| 5 |
Wybierz witrynę Webex i lokalizacje uczestników, dla których chcesz otrzymywać powiadomienia. |
| 6 |
W sekcji Kanał dostawy zaznacz pole wyboru E-mail i wprowadź adresy e-mail osób, które otrzymają alerty. |
| 7 |
Zaznacz pole wyboru Przest rzeń Webex i wprowadź nazwę pomieszczenia, jeśli chcesz otrzymywać wiadomości w tej przestrzeni po osiągnięciu progu. |
| 8 |
Kliknij przycisk Zapisz. |
Możesz włączyć do 10 ostrzeżeń o monitorowaniu jakości spotkań historycznych na organizację.
| 1 |
Zaloguj się do Control Hub i przejdź do Po wiad omienia > Moje reguły. |
| 2 |
Kliknij opcję Utwórz regułę. |
| 3 |
Wybierz opcję Monitorowanie jakości spotkania histor ycznego obok opcji Typ i wprowadź nazwę alertu obok pozycji Tytuł. |
| 4 |
Przełącz przełącznik Stan na włączony, aby otrzymywać powiadomienia o alercie. |
| 5 |
Wybierz witrynę Webex i lokalizacje uczestników, dla których chcesz otrzymywać powiadomienia. |
| 6 |
W sekcji Reg uły ustaw następujące progi:
|
| 7 |
W sekcji Wy zwal acz wybierz czas trwania monitorowania i wprowadź odsetek uczestników, którzy muszą osiągnąć jeden z progów, aby wywołać alert. |
| 8 |
W sekcji Kanał dostawy zaznacz pole wyboru E-mail i wprowadź adresy e-mail osób, które otrzymają alerty. |
| 9 |
Zaznacz pole wyboru Przest rzeń Webex i wprowadź nazwę pomieszczenia, jeśli chcesz otrzymywać wiadomości w tej przestrzeni po osiągnięciu progu. |
| 10 |
Kliknij przycisk Zapisz. |
DlaWebex Calling, możesz skonfigurować następujące alerty:
Dodawanie ostrzeżenia o spadku jakości połączenia
Użyj tego alertu, aby dowiedzieć się, kiedy jakość połączenia w określonych lokalizacjach lub sesja medialna użytkownika spada do niskiej jakości.
Jakość połączenia jest obliczana jako:
- Dobry — zarówno strumień wideo, jak i audio miał drgania poniżej 150 ms, opóźnienie poniżej 400 ms i utratę pakietów poniżej 5%.
- Słaby — zarówno strumień wideo, jak i audio miał drgania powyżej 150 ms, opóźnienie powyżej 400 ms i utratę pakietów powyżej 5%.
Alerty są wysyłane po zakończeniu połączenia. Po otrzymaniu alertu możesz kliknąć Rozwiązywanie problemów z połączeniem, aby przejść bezpośrednio do połączenia w obszarze Rozwiązywanie problemów, jeśli alert monitoruje określonych użytkowników. Jeśli alert monitoruje lokalizacje, możesz kliknąć opcję Wyświetl analizę, aby przejść do zakładki Jakość mediów w obszarze Calling Analytics.
Możesz utworzyć do 10 alertów o obniżeniu jakości połączeń na organizację.
Alerty nie są uruchamiane w punktach podręcznych opartych na wystąpieniu dedykowanym (DI).
| 1 |
Zaloguj się do Control Hub. |
| 2 |
Przejdź do Powiad omienia > Moje zasady. |
| 3 |
Kliknij opcję Utwórz regułę. |
| 4 |
Z listy rozwijanej Usłu ga wybierz opcję Dzw onienie. 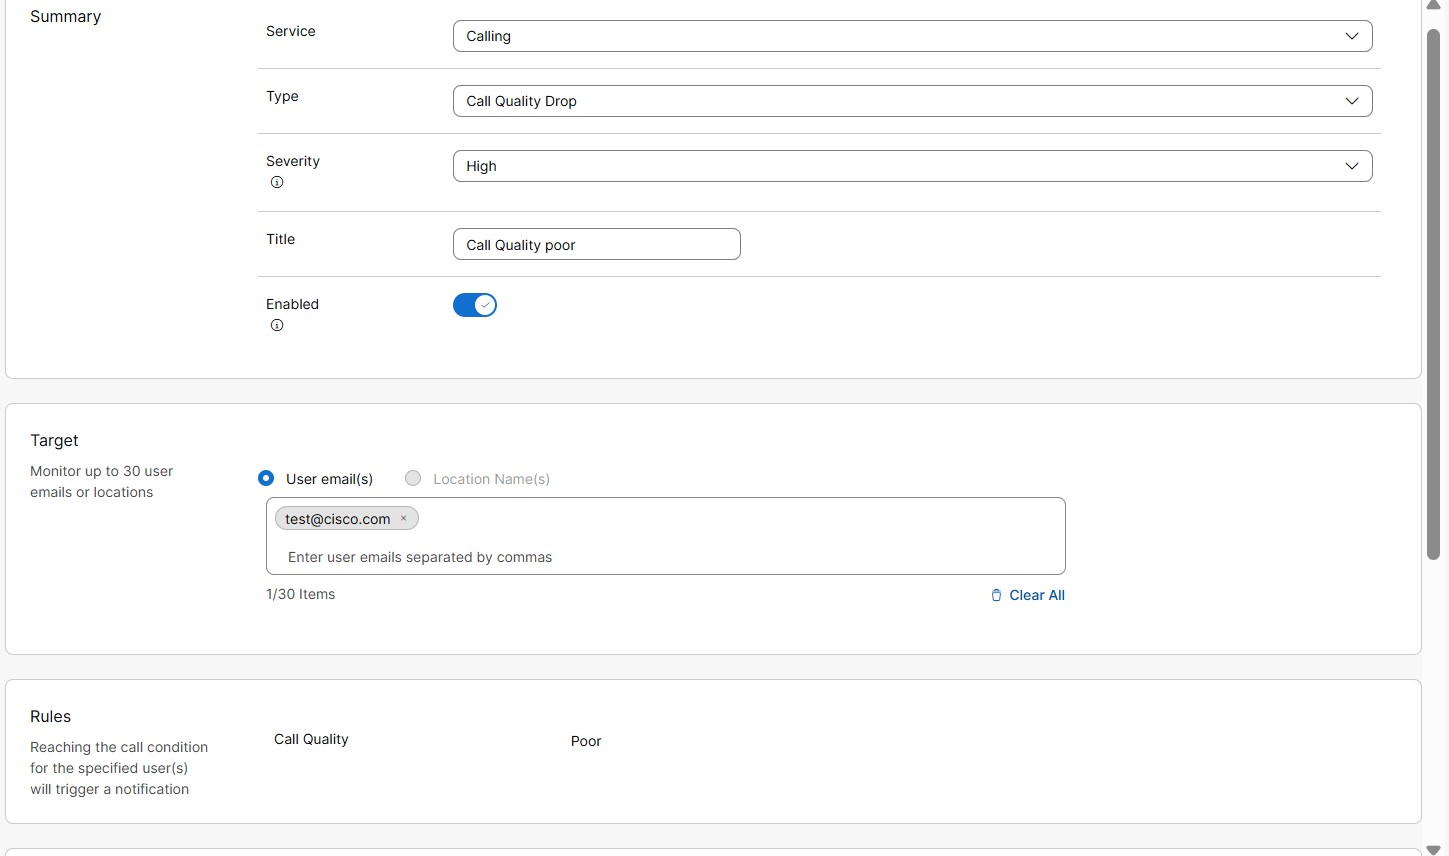
|
| 5 |
Z listy rozwijanej Typ wybierz opcję U pu ść jakość połączenia. |
| 6 |
Z listy rozwi jan ej Poważność. To pole pokazuje, jak poważny lub ważny jest alarm. Możesz wybrać poziom nasilenia jako
wysoki, średni lub niski.
|
| 7 |
Wprowadź tytuł. |
| 8 |
Włącz opcję Włącz one, aby otrzymywać powiadomienia o alercie. |
| 9 |
W sekcji Cel wybierz Adres e-mail użytkownika lub Nazwa (y) lokalizacji. Możesz wprowadzić do 30 adresów e-mail użytkowników lub lokalizacji do monitorowania.
|
| 10 |
W sekcji Kanał dostawy wybierz sposób otrzymywania alertów: 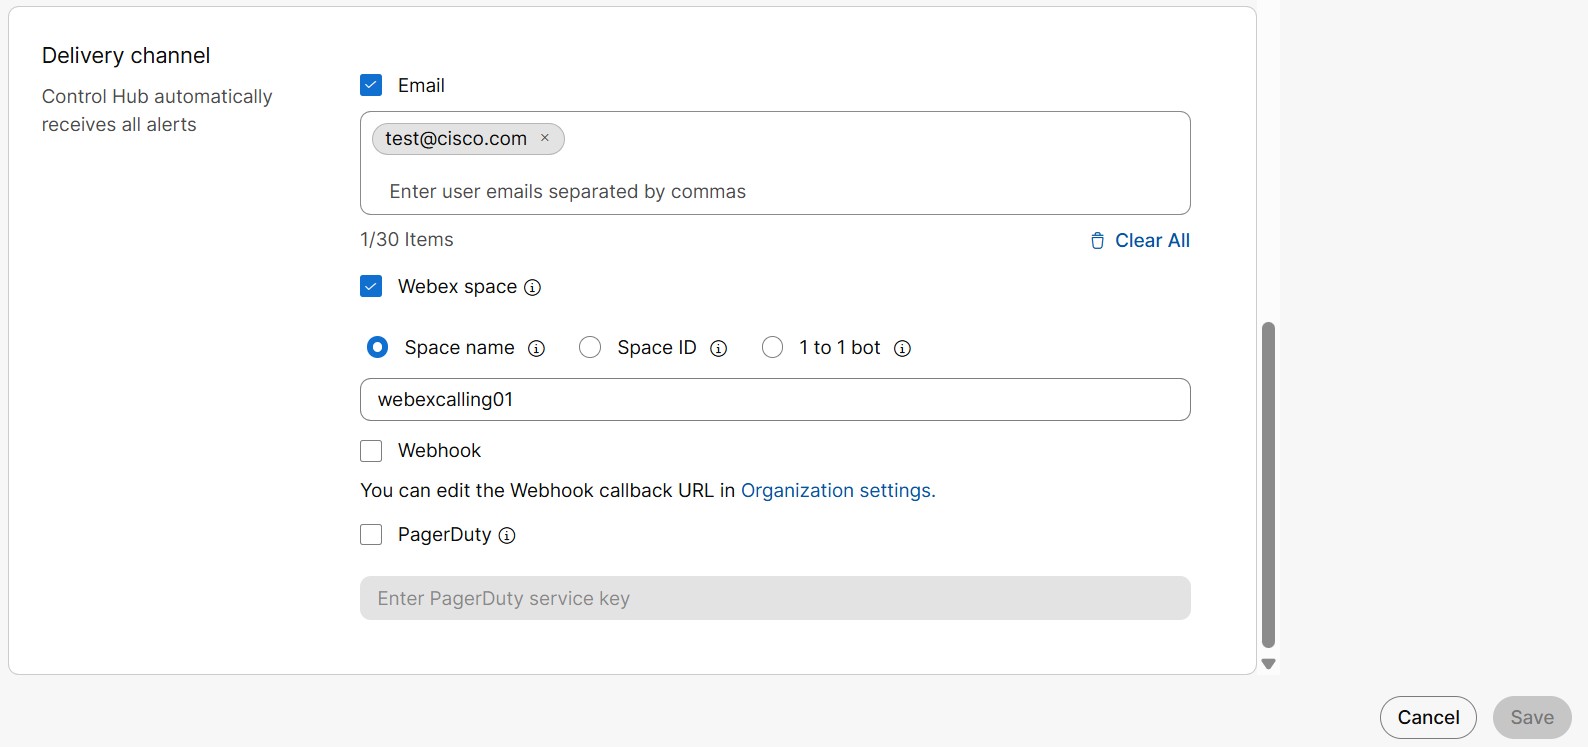
|
| 11 |
Kliknij przycisk Zapisz. |
Dodawanie ostrzeżenia o zmianie stanu bagażnika
Alert jest wysyłany, gdy zmienia się stan monitorowanego bagażnika. Dostępne stany magist rali są online, offline i upośledzone. Możesz skonfigurować, która zmiana stanu powinna wywołać alert.
Poniżej przedstawiono różne statusy pnia:
-
Online - pomyślna rejestracja Local Gateway doWebex Calling.
-
Offline — nieudana rejestracja lokalnej bramy doWebex Calling.
-
Zabur zenia — nieudane połączenie między co najmniej jednym Webex Calling serwerem proxy Edge a lokalną bramą.
-
Nieznany — w trakcie nawiązywania połączenia między Webex Calling a ostatnio dodaną bramą lokalną.
Aby dowiedzieć się więcej o różnych zmianach błędów stanu, zapoznaj się z artykułem centrum pomocy w sekcji Rozwiązywanie problemów z bramą lokal ną.
| 1 |
Zaloguj się do Control Hub. |
| 2 |
Przejdź do Powiad omienia > Moje zasady. |
| 3 |
Kliknij opcję Utwórz regułę. |
| 4 |
Z listy rozwijanej Usłu ga wybierz opcję Dzw onienie. 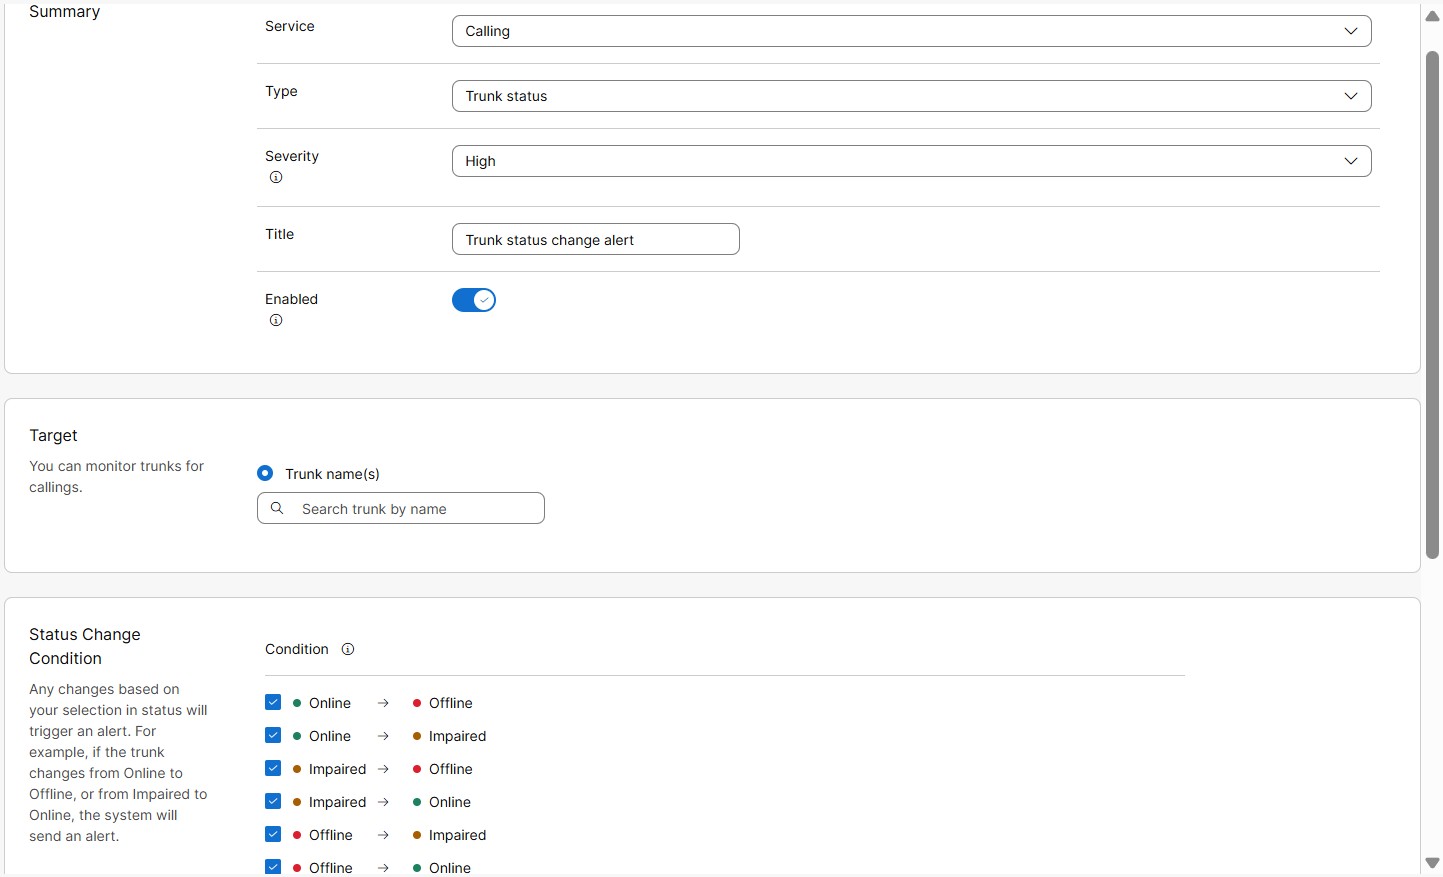
|
| 5 |
Z listy rozwijanej Typ wybierz pozycję Status bagażnika. |
| 6 |
Z listy rozwi jan ej Poważność. To pole pokazuje, jak poważny lub ważny jest alarm. Możesz wybrać poziom nasilenia jako
wysoki, średni lub niski.
|
| 7 |
Wprowadź tytuł. |
| 8 |
Włącz włączone, aby otrzymywać powiadomienia o alercie |
| 9 |
W sekcji C el wybierz Nazwa (y) Trunk (y). Możesz wprowadzić do 30 bagażników do monitorowania.
Alerty nie są uruchamiane w punktach podręcznych opartych na wystąpieniu dedykowanym (DI). |
| 10 |
W sekcji Definicja reguły można zdefiniować regułę, kiedy musi zostać uruchomiony alert. Możesz wybrać wszystkie lub wybrać jedną z następujących zmian stanu:
|
| 11 |
W sekcji Kanał dostawy wybierz sposób otrzymywania alertów:
|
| 12 |
Kliknij przycisk Zapisz. |
Dodawanie ostrzeżenia o ograniczeniu połączeń równoczesnych
Alert jest wysyłany po osiągnięciu limitu progowego jednoczesnych połączeń w systemie magistralnym. Ten alert pomaga zidentyfikować pracowitą godzinę lub dzień, w którym osiągnięta jest pojemność bagażnika w celu obsługi jednoczesnych połączeń.
Kolejne alerty są uruchamiane w wybranym przedziale czasowym, jeśli skonfigurowany próg nadal jest naruszany.
| 1 |
Zaloguj się do Control Hub. |
| 2 |
Przejdź do Powiad omienia > Moje zasady. |
| 3 |
Kliknij opcję Utwórz regułę. |
| 4 |
Z listy rozwijanej Usłu ga wybierz opcję Dzw onienie. 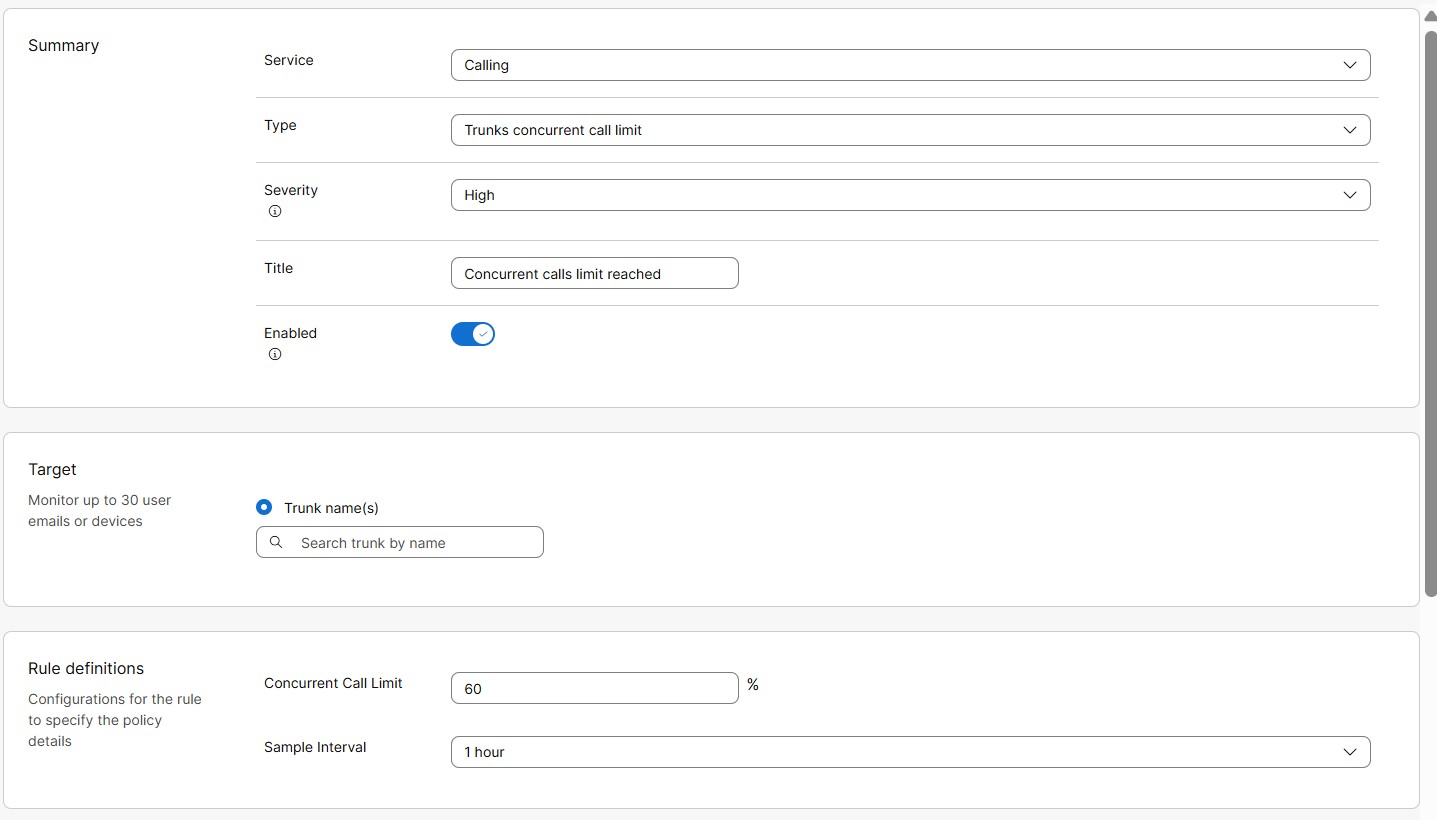
|
| 5 |
Z listy rozwijanej Typ wybierz opcję Limit połączeń równoczesnych Trunk. |
| 6 |
Z listy rozwi jan ej Poważność. To pole pokazuje, jak poważny lub ważny jest alarm. Możesz wybrać poziom nasilenia jako
wysoki, średni lub niski.
|
| 7 |
Wprowadź tytuł. |
| 8 |
Włącz opcję Włącz one, aby otrzymywać powiadomienia o alercie. |
| 9 |
W sekcji C el wybierz Nazwa (y) Trunk (y). Możesz wprowadzić do 30 bagażników do monitorowania.
Alerty nie są uruchamiane w punktach podręcznych opartych na wystąpieniu dedykowanym (DI). |
| 10 |
W sekcji Definicje reguł można zdefiniować regułę, kiedy musi zostać uruchomiony alert. Wprowadź następujące wartości dla warunku progu limitu wywołania równoczesnego: |
| 11 |
W sekcji Kanał dostawy wybierz sposób otrzymywania alertów:
|
| 12 |
Kliknij przycisk Zapisz. |
Alert wygaśnięcia certyfikatu Trunk
Alert jest wysyłany, gdy certyfikat magistrali opartego na certyfikacie wkrótce wygaśnie lub wygasł. Jest to alert generowany przez system, domyślnie włączony dla organizacji z pakietami bazującymi na certyfikatach.
Przed wygaśnięciem certyfikatu automatyczne alerty są wysyłane we wstępnie zdefiniowane dni, takie jak 60 dzień, 30 dzień, 15 dzień i 7 dzień przed wy ga śnięciem. Po wygaśnięciu certyfikatu alert jest wysyłany natychmiast i tylko raz. Nie są wysyłane żadne kolejne alerty.
Alerty nie są uruchamiane w punktach podręcznych opartych na wystąpieniu dedykowanym (DI).
Lista tras wywołuje alarm zablokowany
Gdy liczba połączeń równoczesnych przekroczy limit licencji Połączenia listy tras, dozwolona jest do 20% dodatkowej pojemności (pęknięcia). Gdy głośność połączeń off-net (PSTN) przekracza 20% limitów pęknięcia, są one zablokowane. Do użytkownika zostanie wysłany alert o zablokowaniu połączeń z Listą tras.
Zanim zaczniesz
| 1 |
Zaloguj się do Control Hub. |
| 2 |
Przejdź do Powiad omienia > Wszystkie reguły. Zostanie wyświetlona lista wszystkich reguł.
|
| 3 |
Wybierz Lista tras Powiadomienia o zablokowaniu alertu. Lista tras Calls Blocked alert to alert generowany przez system. Dlatego możesz edytować tylko kilka jego szczegółów, jak wspomniano w następnych krokach. 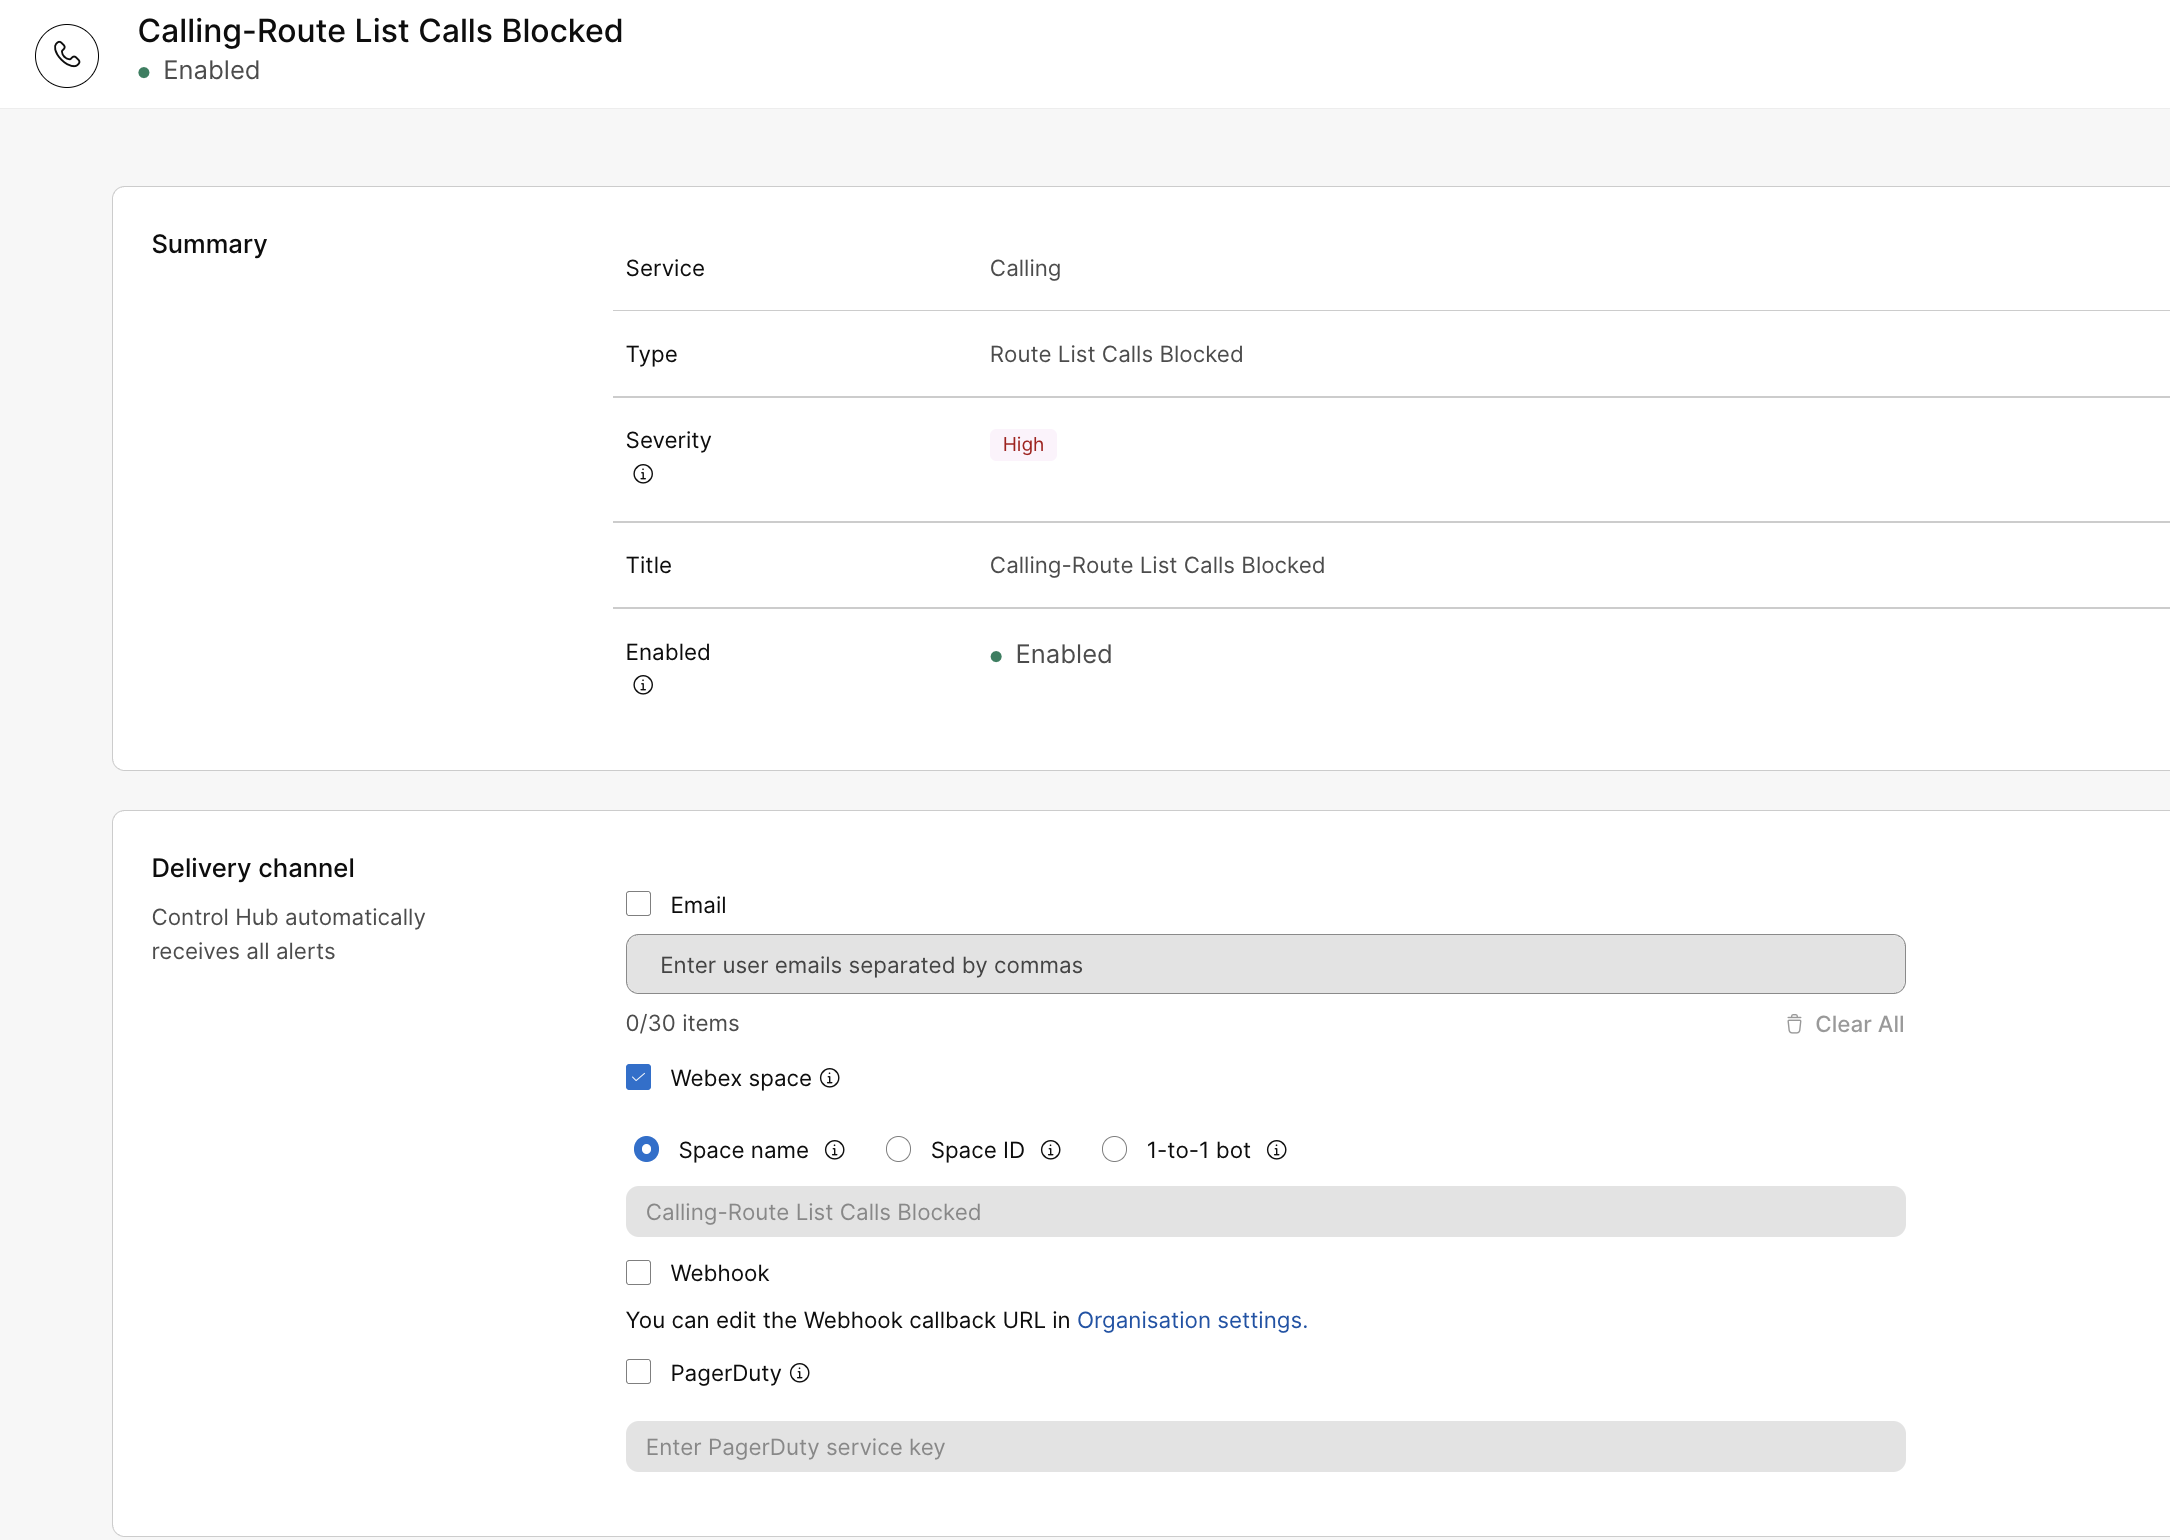
|
| 4 |
W sekcji Kanał dostawy wybierz sposób otrzymywania alertów:
|
| 5 |
Kliknij przycisk Zapisz. |
Istnieją dwie kategorie alertów serwisowych dla wystąpienia dedykowanego: alerty konserwacyjne i alerty proaktywne.
Alerty konserwacyjne
System domyślnie włącza alerty konserwacyjne. Administratorzy partnerów lub klientów powinni zweryfikować lub skonfigurować kanał dostawy, aby otrzymywać powiadomienia za pośrednictwem poczty elektronicznej i/lub przestrzeni Webex . Alerty konserwacyjne służą do wysyłania powiadomień o konserwacji, awariach i komunikacji z in cydentami.
Aby dodać informacje o kanale dostawy, aby otrzymywać powiadomienia o konserwacji:
- Zaloguj się do Control Hub i przejdź do Po wiad omienia > Wszystkie reguły.
- Kliknij opcję Po wiadomienia o połączeniach-konserwacji i awariach i przewi ń w dół do kanału dostawy.
- Zaznacz jedno lub oba pola wyboru Poczty e-mail lub Webex, aby otrzymywać powiadomienia na preferowanym kanale.
Możesz dodać do 30 identyfikatorów e-mail.
Aby otrzymywać powiadomienia w przestrzeni Webex, musisz mieć licencję Messaging. Jeśli dostęp do botów jest włączony w aplikacji/botach i możesz być członkiem pokoju organizacji, otrzymasz powiadomienia. W przeciwnym razie skontaktuj się z administrat orem organizacji, aby rozwiązać problem.
Możesz wybrać Webhook, jeśli masz włączone Webhook na poziomie organizacyjnym. Aby uzyskać więcej informacji, zobacz Włącz anie haczyków sieciowych dla alertów w Centrum sterowania.
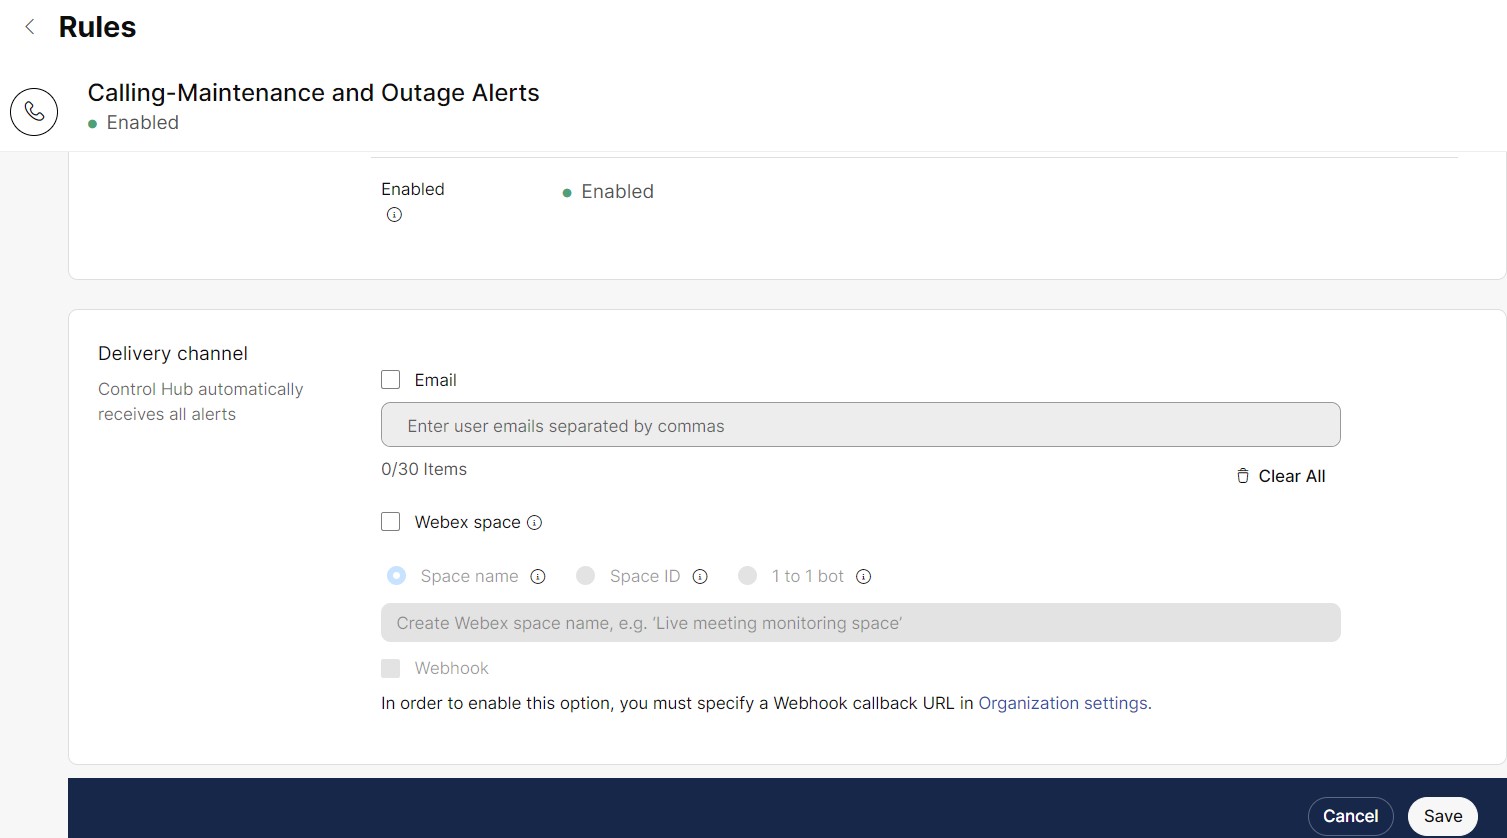
- Wprowadź informacje o przestrzeni e-mail i Webex i kliknij Zapisz, aby zapis ać zmiany.
Za każdym razem, gdy następuje konserwacja, Control Hub automatycznie wyświet la baner ze szczegółami klastra, regionem oraz zaplanowaną datą i godziną.

Proaktywne alerty
Administratorzy partnerów lub klientów mogą subskrybować proaktywne alerty i powiadomienia o zdarzeniach dnia drugiego lub trzeciego dnia i zdecydować, czy zostaną dostarczone pocztą elektroniczną, przestrzeniami aplikacji Webex lub oba, wybierając Kanał dostawy podczas tworzenia alertu.
Na przykład: Unified CM Video Conf Bridge Out of Resource Count High, Unified CM MTP O ut of Resource Count High.
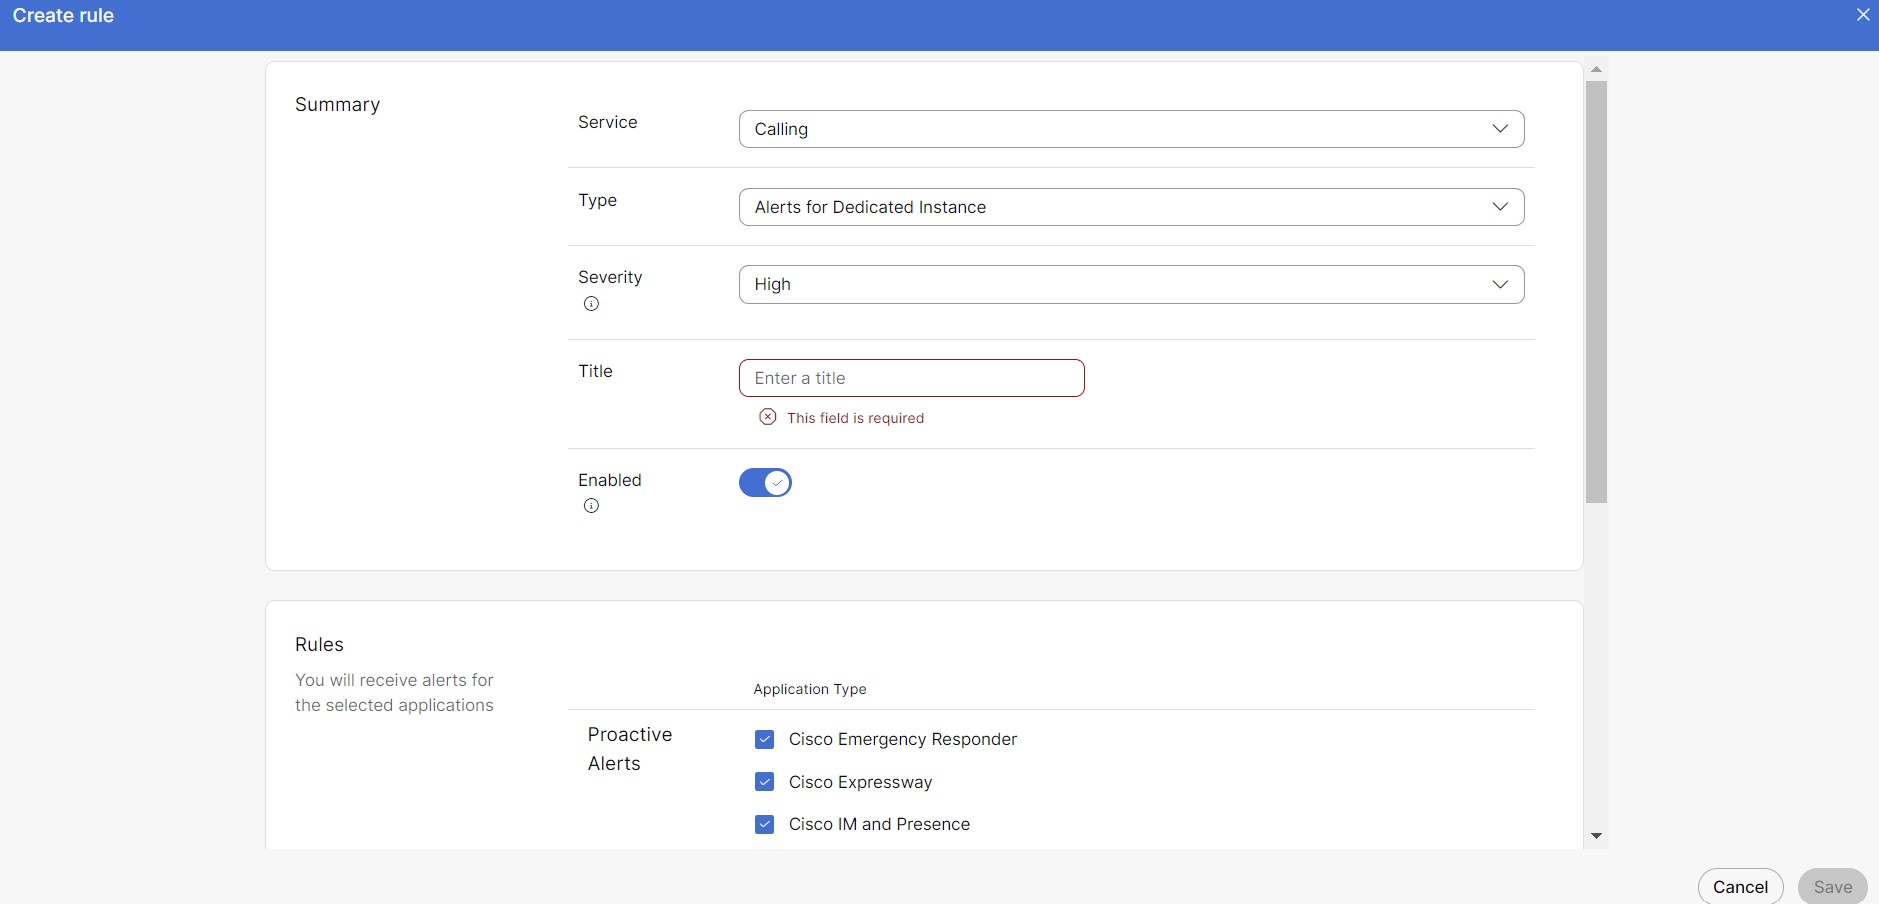
Aby utworzyć proaktywną regułę alertów
Tylko partner lub administrator klienta z pełnymi uprawnieniami administratora może tworzyć reguły.
- Zaloguj się do Control Hub i przejdź do Po wiad omienia > Moje reguły.
- Wybierz opcję Utwórz regułę.
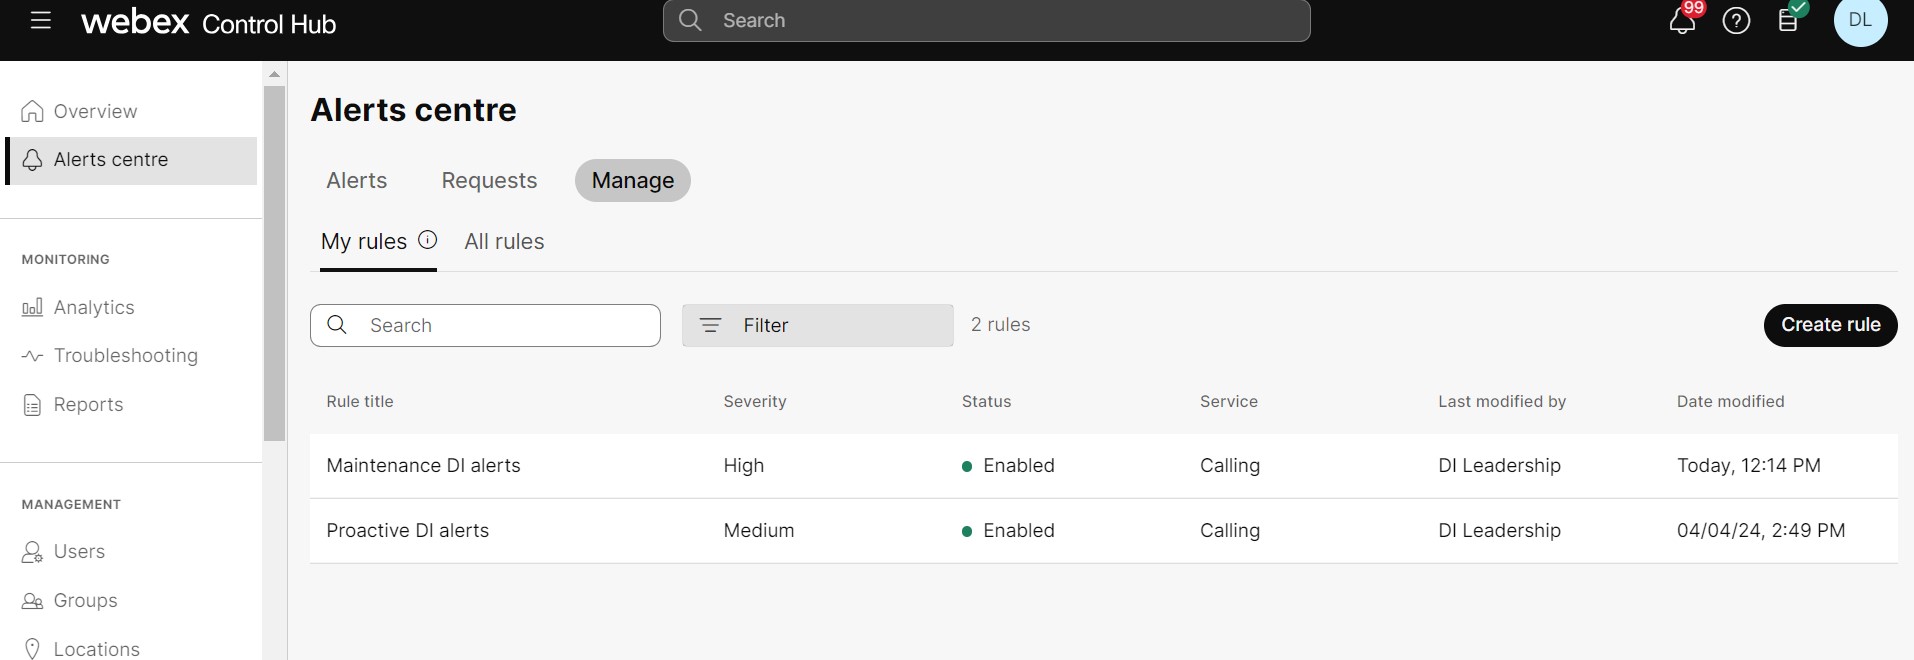
- W sekcji Pod sumowanie:
- Wybierz opcję Dzwoni enie z listy rozwijanej Usłu ga.
- Wybierz opcję Alerty dla wystąpi enia dedykowanego z listy rozwijanej Typ.
- Wybierz preferowaną dot kliwość. Domyślnie dotkliwość jest wysoka.
-
Zalecamy tworzenie reguł dla proaktywnych alertów o średniej lub niskiej nasileniu.
-
Otrzymujesz alerty, które odpowiadają lub przekraczają poziom dotkliwości wybrany podczas konfigurowania reguły.
-
- Dodaj tytuł dla nowej reguły.
- Wszystkie pola wyboru w sekcji Reg uły są domyślnie zaznaczone. Usuń zaznaczenie tych na podstawie swoich preferencji.
- Wybierz Kanał dostawy, aby otrzymać alert.
Możesz wybrać Webhook, jeśli masz włączone Webhook na poziomie organizacyjnym. Aby uzyskać więcej informacji, zobacz Włącz anie haczyków sieciowych dla alertów w Centrum sterowania.
- Kliknij przycisk Zapisz.
Po utworzeniu reguł rozpoczęcie otrzymywania powiadomień zajmuje maksymalnie 6 godzin.
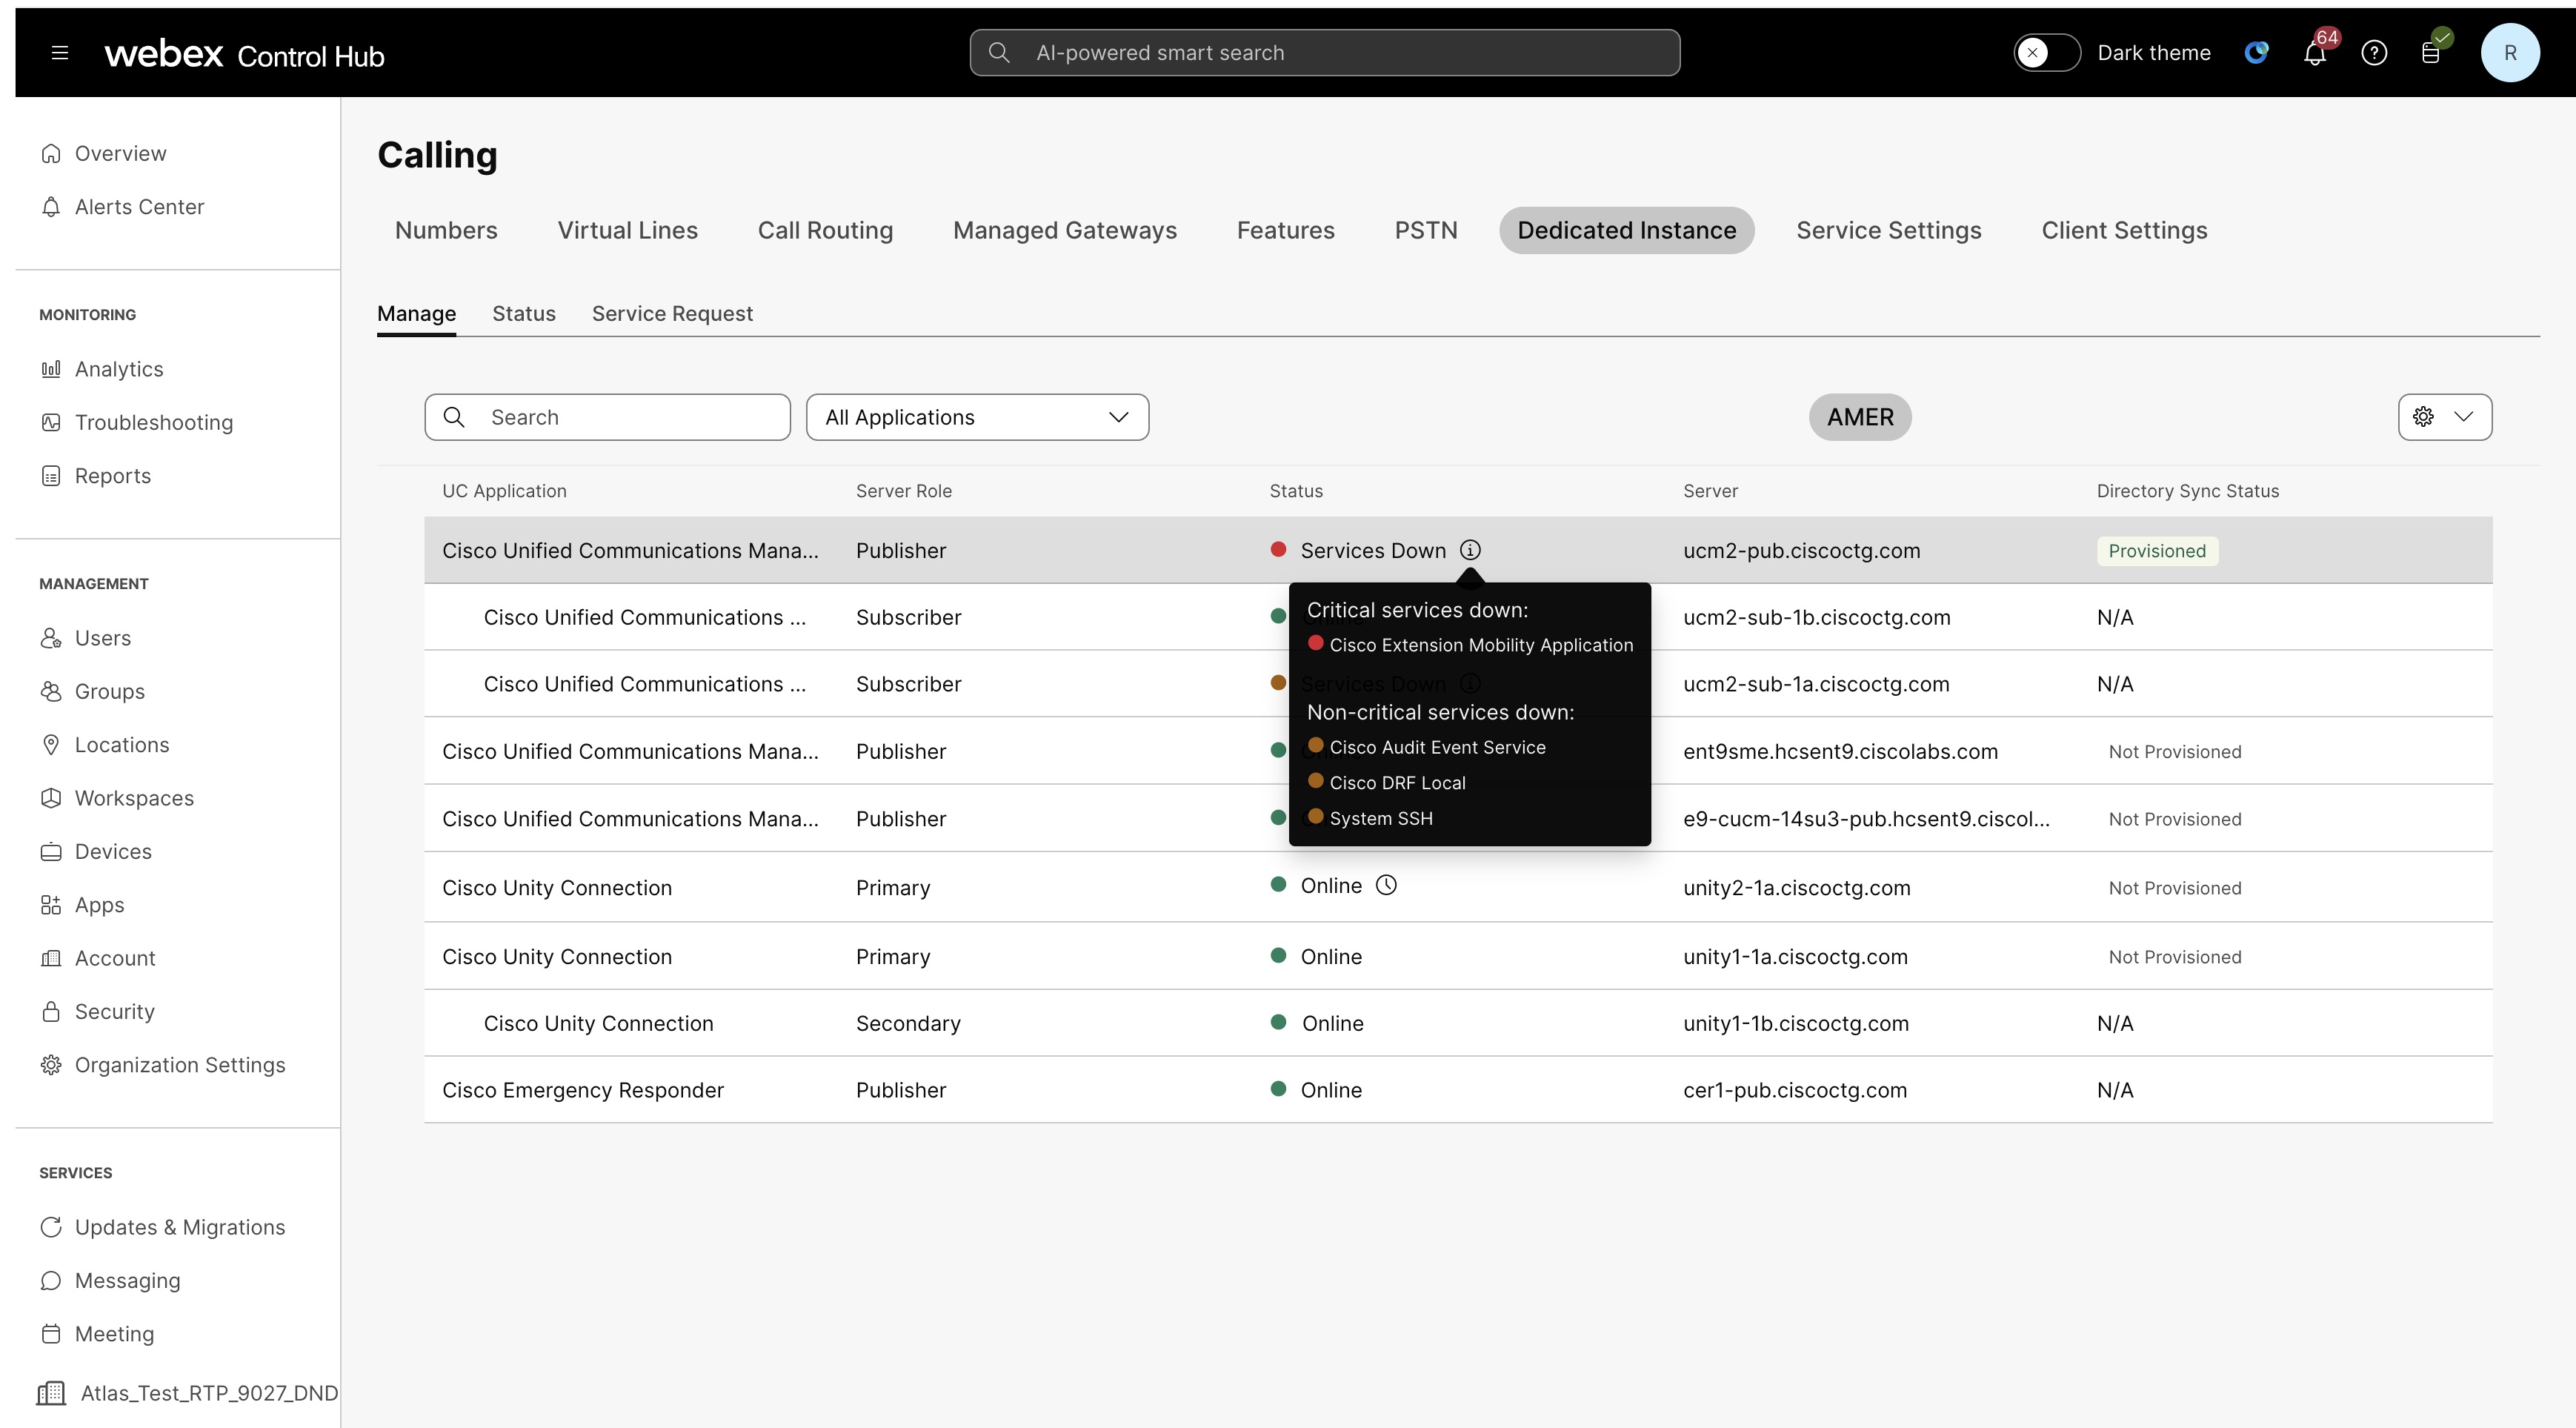
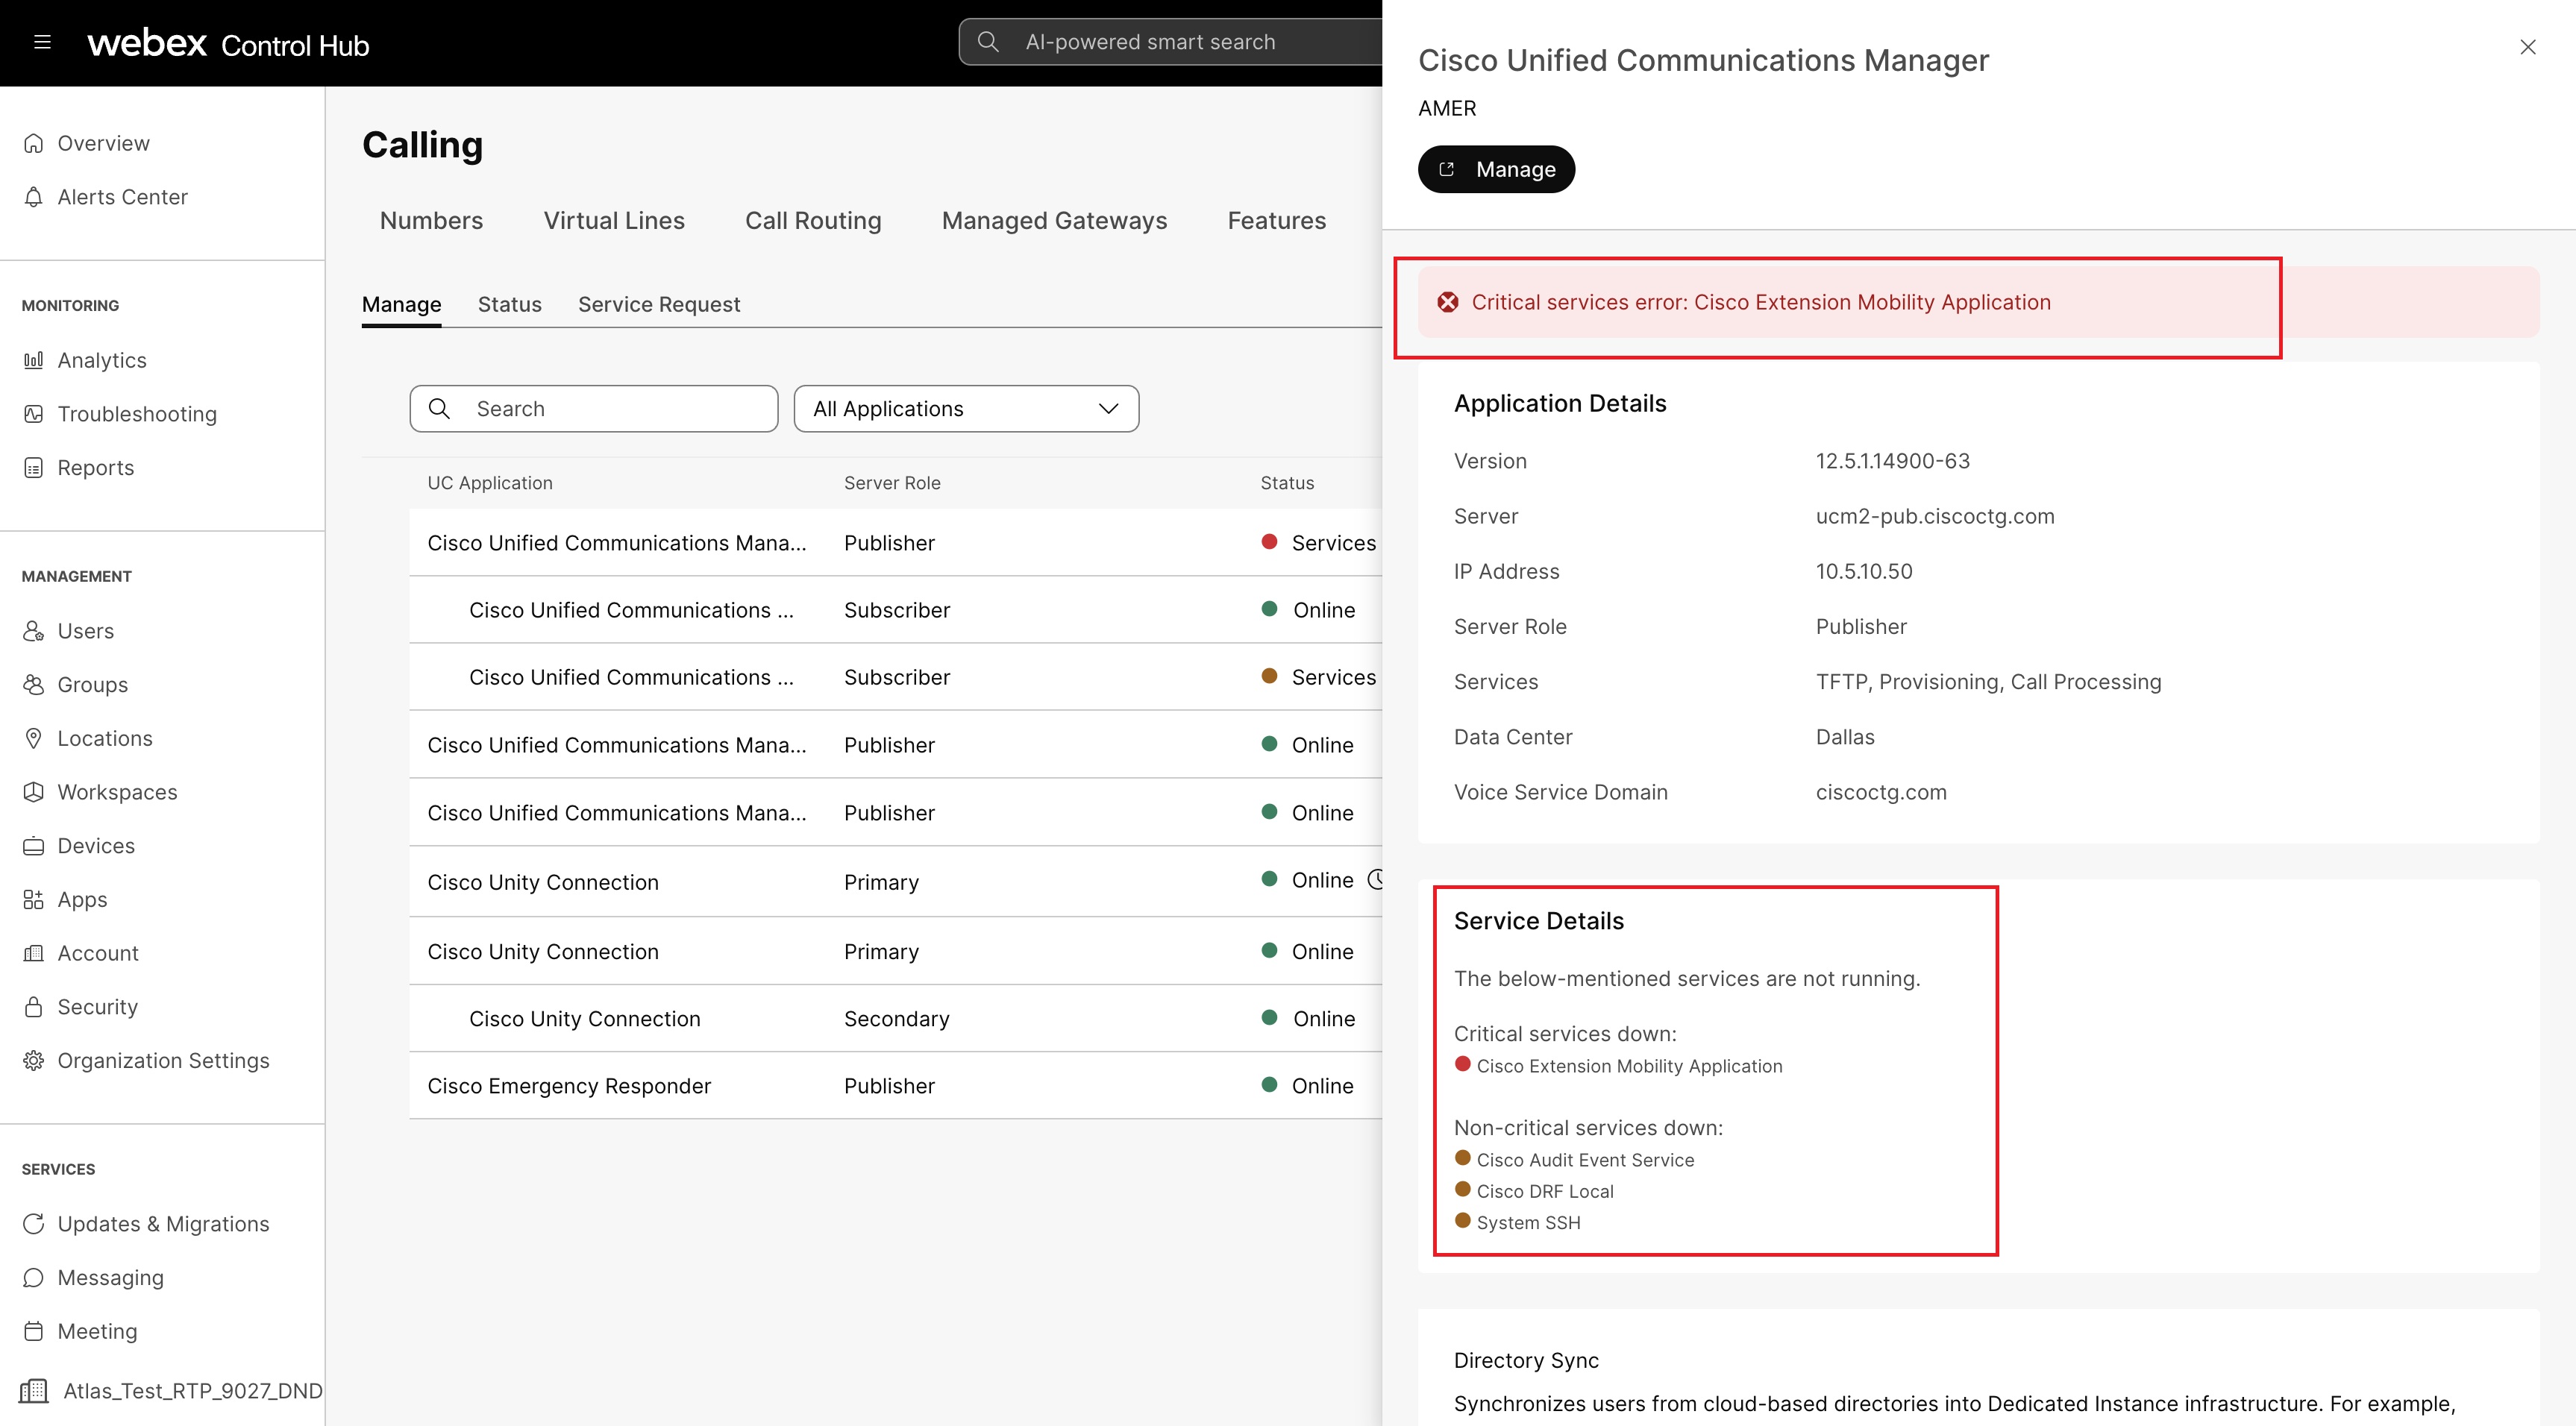
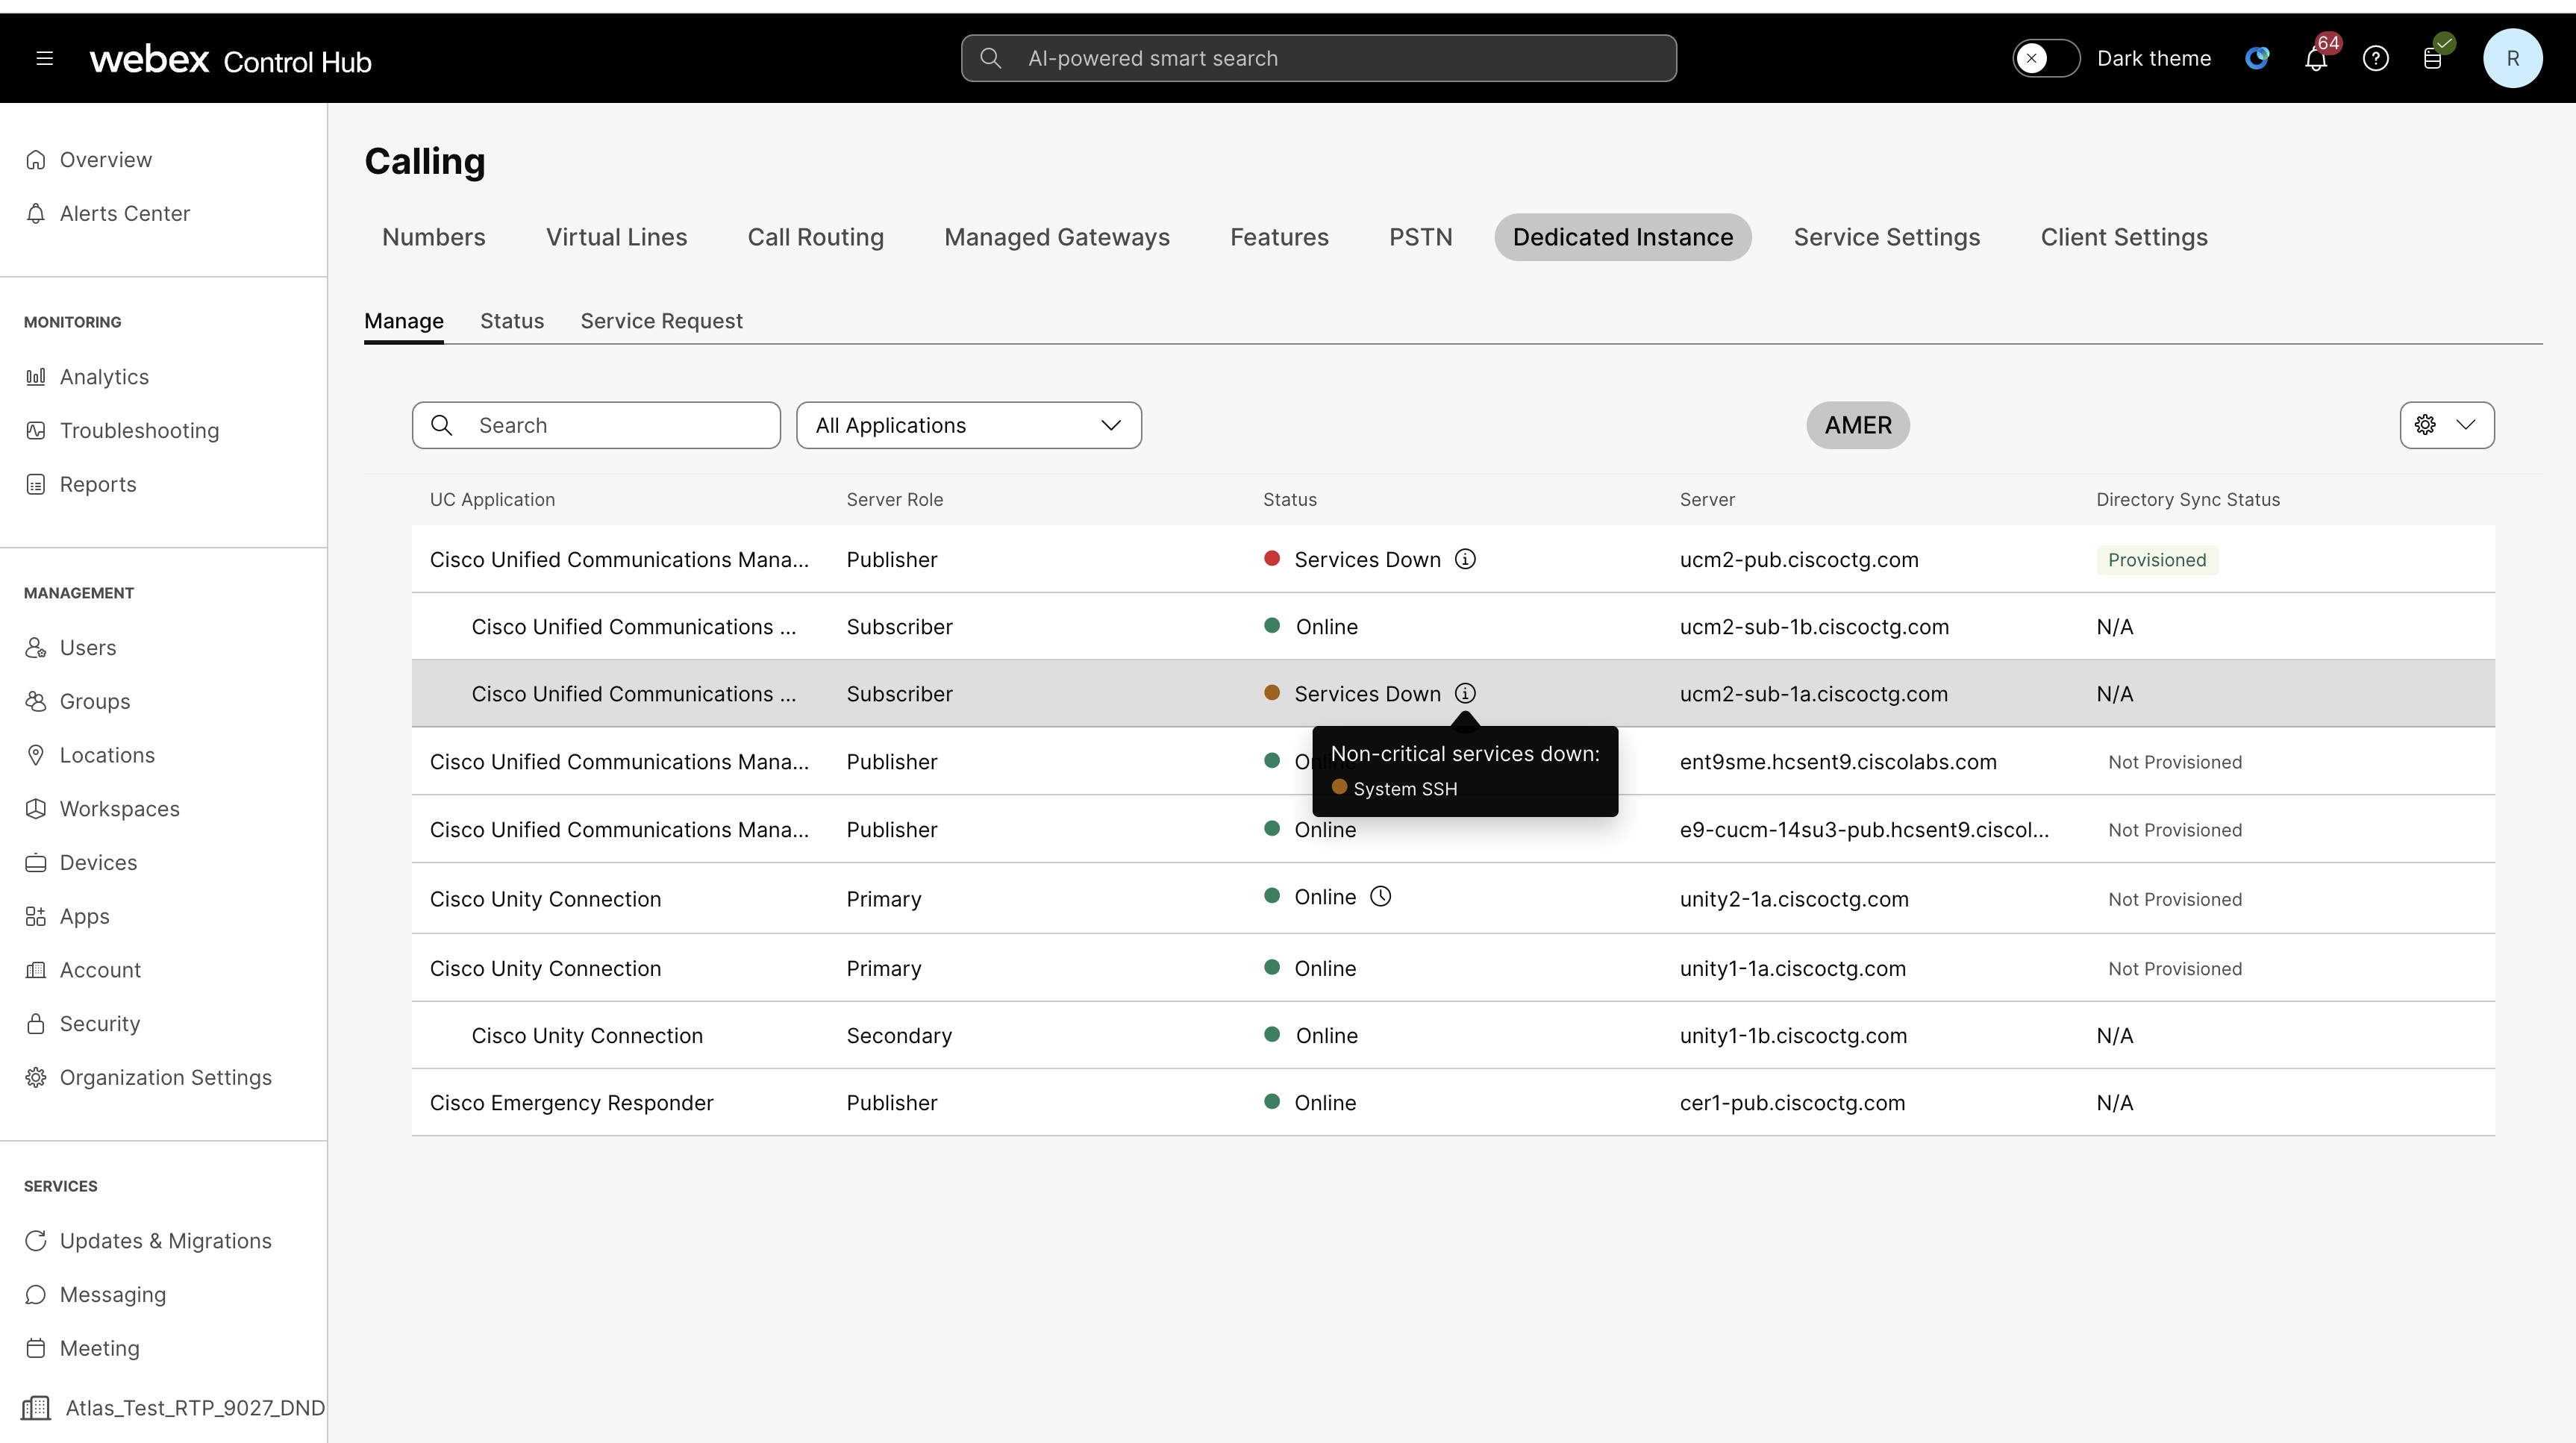
Status alarmu i ich legendy
Control Hub konsoliduje stany wielu usług aplikacji UC, statusy agenta i stan konserwacji każdego węzła.
Status usług dla każdego węzła jest odświeżany co 30 sekund.
|
Krytyczne alerty |
|
|
|
|
Alerty niekrytyczne |
|
|
Wszystkie inne usługi UC, które nie są wymienione powyżej, są uważane za usługi niekrytyczne. |
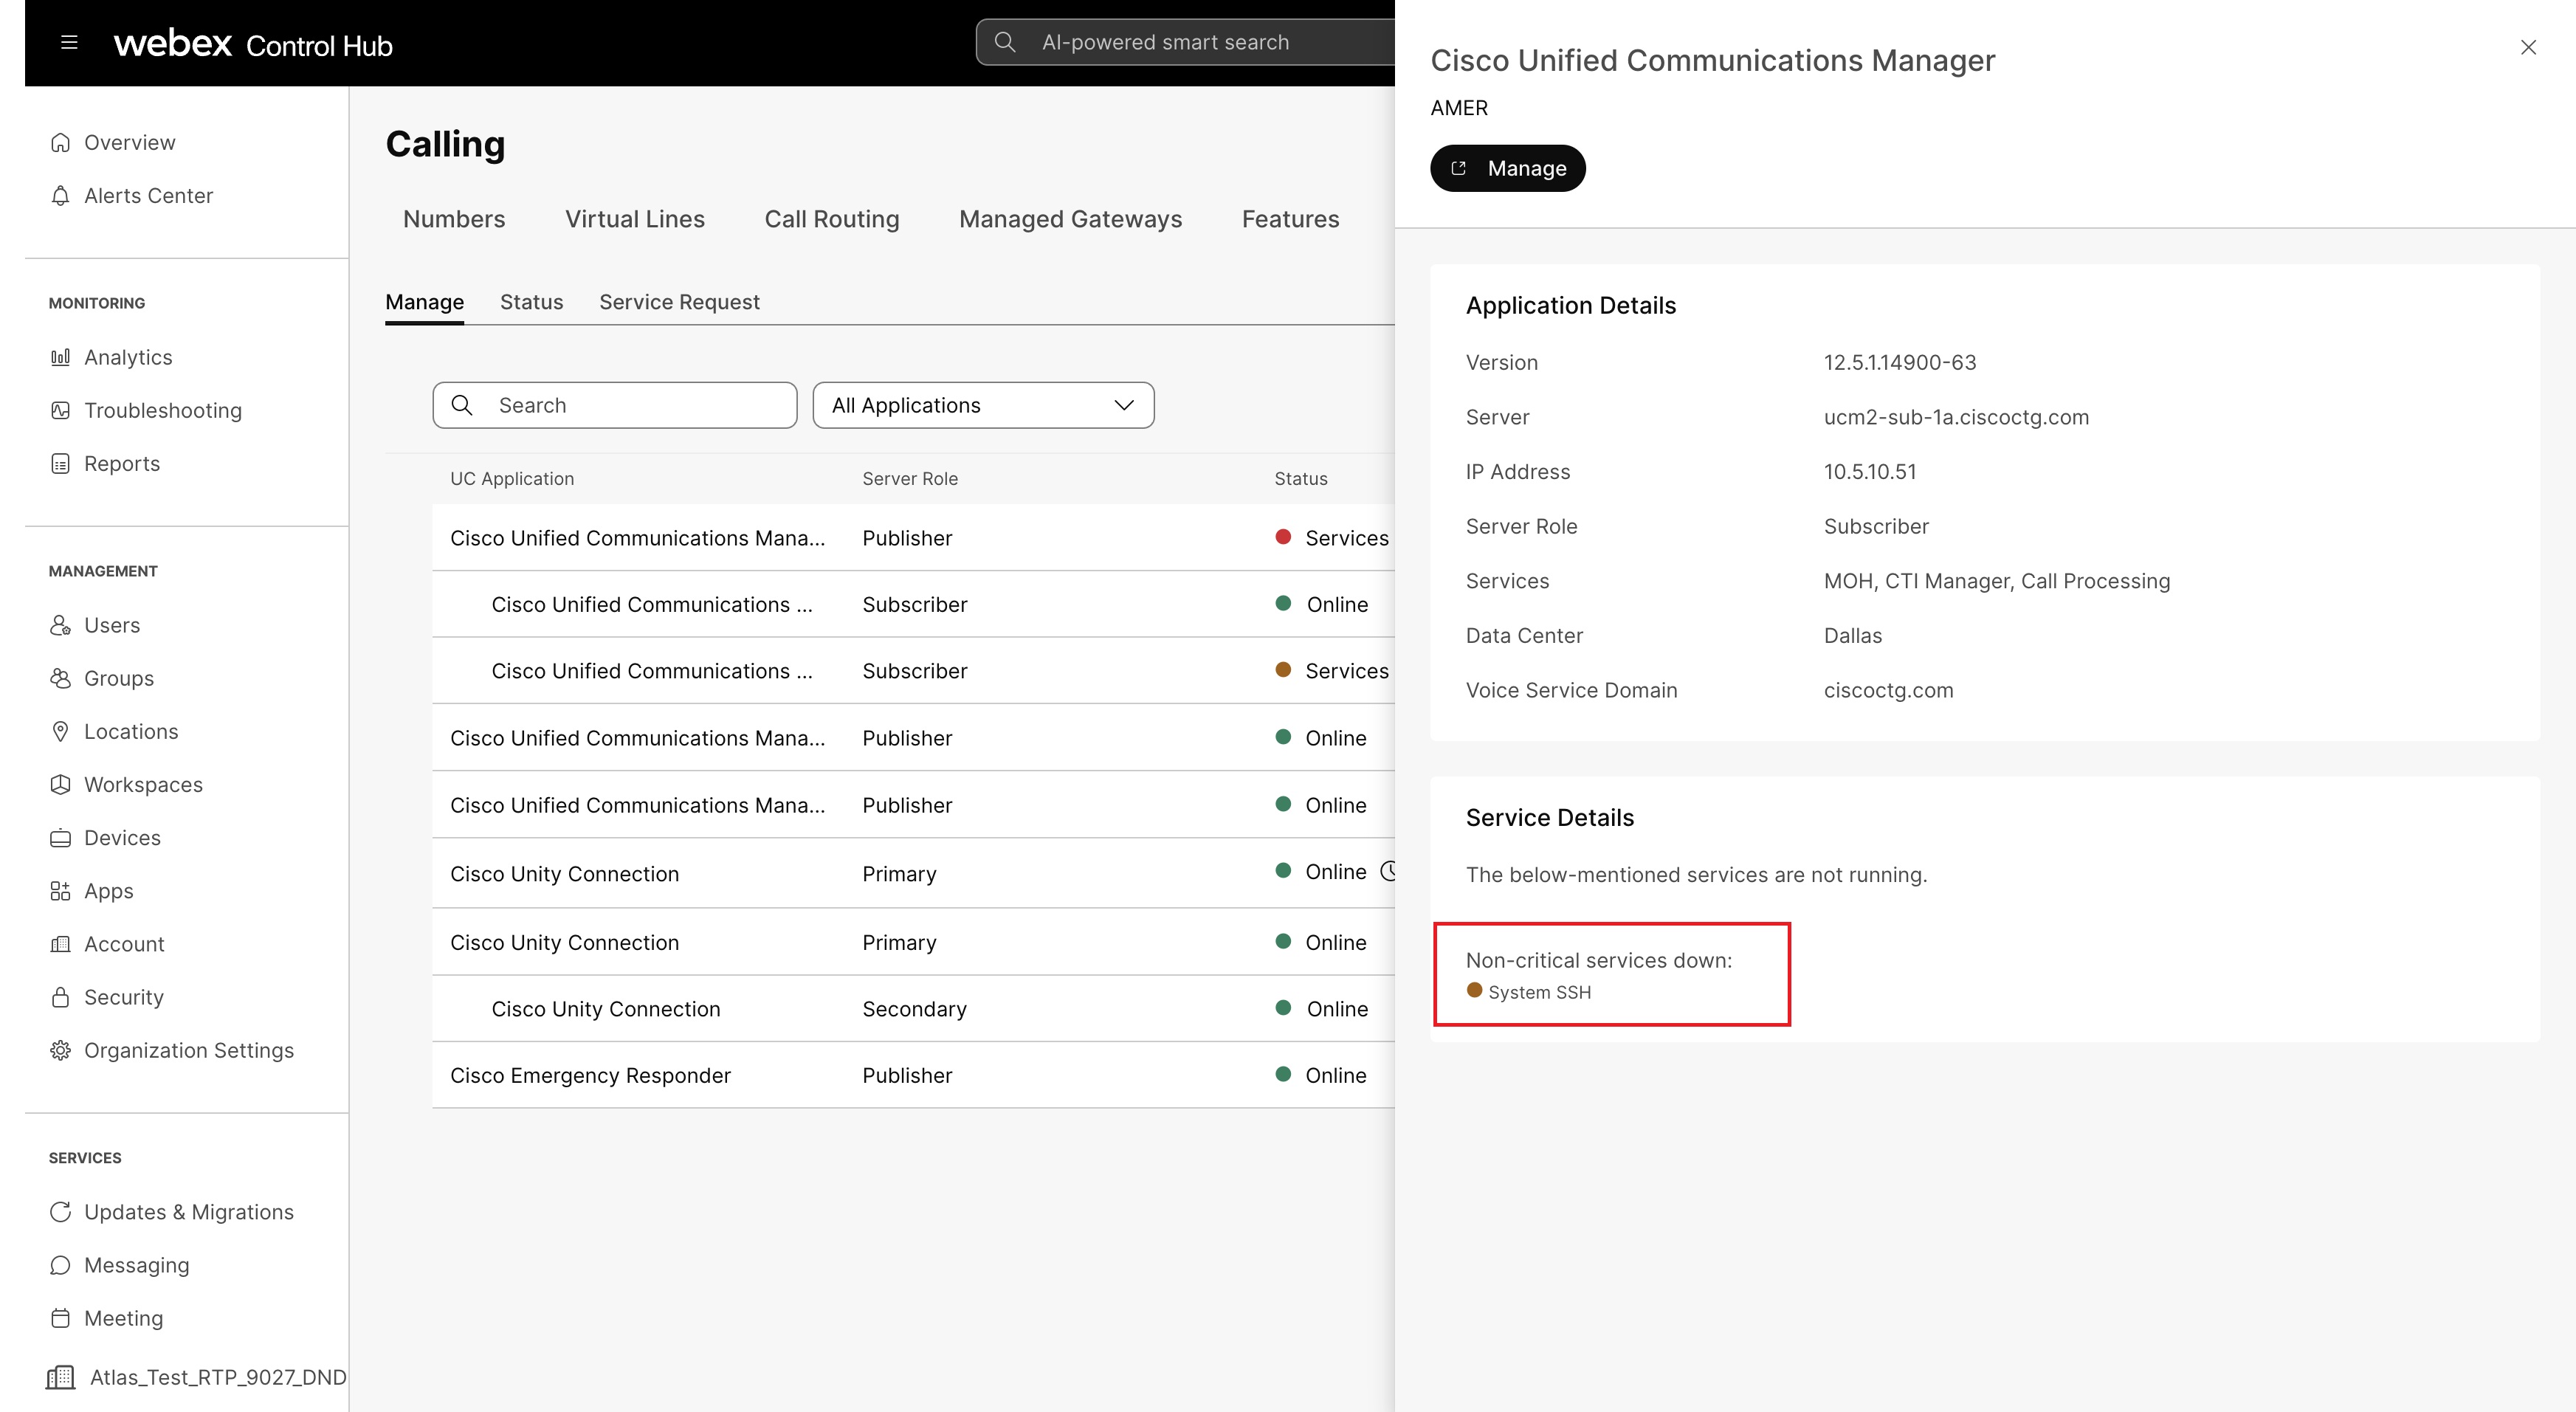
Legendy alarmowe
| Status | Kolor | Opis |
| Online | Zielony | Wskazuje, że węzeł działa normalnie bez żadnych problemów |
| Konserwacja | Pomarańczowy | Wskazuje, że węzeł jest poddawany konserwacji |
| Usługi w dół | Czerwony | Wskazuje, że jedna lub więcej usług krytycznych nie działa w węźle |
| Usługi w dół | Pomarańczowy | Wskazuje, że jedna lub więcej usług niekrytycznych jest wyłączonych w węźle lub agent jest w trybie offline |
Alert o wygaśnięciu certyfikatu
Control Hub wysyła powiadomienia o wygaśnięciu certyfikatu do klientów na 67 dni przed datą wygaśnięcia, a następnie co 12 dni do czasu odnowienia certyfikatu.
- Certyfikaty będące własnością klienta i zarządz ane — z centrum sterowania wysyłany jest proaktywny alert, a Ty jesteś odpowiedzialny za odnawianie certyfikatu i zarządzanie nim.
- Certyfikaty posiadane i zarządzane przez Cisco — z centrum sterowania wysyłany jest proaktywny alert, a my odpowiadamy za odnawianie certyfikatu i zarządzanie nim.
Skonfiguruj proaktywny alert, aby otrzymywać powiadomienie o wygaśnięciu certyfikatu.
Definicje alarmów stanu aplikacji Control Hub
Lista dostępnych definicji alarmów dla wystąpienia dedykowanego zawiera sekcja Definic je alar mów stanu aplikacji Control Hub.
W przypadku alertów aplikacji Unified Communication można skonfigurować poniższe alerty:
- Alerty o krytycznych zdarzeniach aplikacji UC - Otrzymuj powiadomienia o obsługi wanych zdarzeniach krytycznych zebrane z aplikacji UC.
- Alerty o zdarzeniach anomalii opartych na sztucznej inteligen cji - Otrzymuj alerty oparte na sztucznej inteligencji dla takich scenariuszy, jak anomalia telefonu, rejestracja telefonu i anomalia połączeń.
Aby uzyskać więcej informacji, zapoznaj się z sekcją Alerty w centrum sterowania.
Zanim zaczniesz
- Aby utworzyć reguły alertów, musisz być partnerem lub administratorem klienta z pełnymi uprawnieniami administratora.
- Wiadomości muszą być włączone dla organizacji, jeśli chcesz wysyłać alerty do przestrzeni aplikacji Webex.
- Aby można było używać webhooków jako kanału dostarczania, należy włączyć haczyki internetowe na poziomie organizacji.
Zdarzenia krytyczne aplikacji Unified Communication
Ta reguła służy do otrzymywania alertów o krytycznych zdarzeniach. Zdarzenia źródłowe pochodzą z aplikacji UC i są mapowane zgodnie z wymaganiami określonymi przez administratora podczas tworzenia reguły.
Jak utworzyć regułę
- Zaloguj się do Control Hub i przejdź do Po wiadomienia > Moje reguły.
- Kliknij opcję Utwórz regułę.
- W sekcji Pod sumowanie skonfiguruj regułę usług.
- Z listy Usługa wybierz opcję Dzw onienie.
- Z listy Typ wybierz krytyczne zdarzenia aplikacji Cloud Intelligence UC.
- Wybierz preferowaną dot kliwość.
- To pole pokazuje, jak poważny lub ważny jest alarm. Możesz wybrać poziom nasilenia jako Wyso ki, Śred ni lub Niski.
- Zapoznaj się z sekcją Tabela ciężkości, aby dowiedzieć się więcej na temat centrum sterowania i nasilenia typu alertu.
- Zapoznaj się z tabelą listy zdarzeń krytycznych, aby dowiedzieć się więcej o różnych nazwach alertów, opisie i poziomie dotkliwości.
- Wprowadź tytuł nowej reguły.
- Sprawdź, czy przełącznik alertów jest WŁĄCZ ONY, aby otrzymywać powiadomienia dotyczące
alertu.
Po wyłączeniu użytkownicy nie otrzymają alertów.
- W sekcji Definicja reguły wybierz typ aplikacji i wybierz klaster aplikacji jako całość lub skojarzony klaster, który powinien otrzymywać krytyczne alerty.
- W sekcji Kanał dostawy wybierz sposób otrzymywania alertów:
- E-mail— Wprowadź adresy e-mail osób, które otrzymają alerty.
- Webex space— Wprowadź nazwę pomieszczenia, aby otrzymać alert jako wiadomości w sp
acji. Bot wysyła wiadomości tylko do odbiorców, którzy są dodawani do kanału dostarczania wiadomości e-mail.
Aby aplikacja Webex mogła używać przestrzeni jako kanału dostawy, Twoja organizacja musi mieć włączoną obsługę wiadomości.
- Webhook— zaz nacz to pole wyboru, jeśli chcesz używać alertu z aplikacjami innych firm.
- Kliknij przycisk Zapisz.
Po utworzeniu reguł rozpoczęcie otrzymywania powiadomień zajmuje maksymalnie 6 godzin.
Tabela ciężkości
Monitorowanie wysyła alerty o krytycznych zdarzeniach aplikacji UC tylko dla poniższych czynników:
| Poważność koncentratora sterowania | Typ alertu Poważność |
|---|---|
|
Wysoki Wysyła tylko krytyczne zdarzenia o najwyższym priorytecie. | Krytyczny, Alarm |
|
Średni Wysyła zdarzenia o wysokim priorytecie i zdarzenia krytyczne średniego priorytetu. | Krytyczny, Alarm, Błąd, Ostrzeżenie |
|
Niski Wysyła wszystkie obsługiwane zdarzenia krytyczne w regułach. | Krytyczny, Alarm, Błąd, Ostrzeżenie, Informacja |
Lista zdarzeń krytycznych
Lista zdarzeń krytycznych pokazuje alerty, które mogą wyzwalać powiadomienia dla wybranych klastrów aplikacji o nasileniu i UC.
| Nazwa alertu | Opis | Poważność |
|---|---|---|
| CiscodrFailure | Ten alert pojawia się podczas generowania zdarzenia DRFFAiLure. | Krytyczny |
| Sprzęt awaryjny | Ten alert pojawia się podczas generowania zdarzenia HardwareFailure. Oznacza to, że wystąpiło zdarzenie awarii sprzętu (awarie dysku, awarie zasilania,...) . | Krytyczny |
| LogFilesEarchStringFound | Ten alert pojawia się podczas generowania zdarzenia LogFileSearchStringFound. Oznacza to, że ciąg wyszukiwania został znaleziony w pliku dziennika. | Krytyczny |
| SysLogStringMatchFound | Ten alert pojawia się podczas generowania zdarzenia SysLogStringMatchFound. Oznacza to, że znaleziono komunikat syslog z pasującym ciągiem wyszukiwania. | Krytyczny |
| SysLogSeverityMatchFound | Ten alert pojawia się podczas generowania zdarzenia SysLogSeverityMatchFound. Oznacza to, że znaleziono komunikat syslog z odpowiednim poziomem nasilenia. | Krytyczny |
| LogPartitionHighWatermarkExceed | Ten alert występuje, gdy zostanie wygenerowane zdarzenie LogPartitionHighWatermarkExceed. Oznacza to, że procent zużytego miejsca na dysku w partycji dziennika przekroczył skonfigurowany wysoki znak wody. | Krytyczny |
| LogPartitionLowWatermarkExceed | Ten alert występuje, gdy zostanie wygenerowane zdarzenie LogPartitionLowWatermarkExceed. Oznacza to, że procent zużytego miejsca na dysku w partycji dziennika przekroczył skonfigurowany znak niskiego poziomu wody. | Krytyczny |
| Część zapasowaWysoki znak wodnyPrzekroczony | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie SparePartitionHighWatermarkExceed. Oznacza to, że procent zużytego miejsca na dysku w zapasowej partycji przekroczył skonfigurowany wysoki znak wody. | Krytyczny |
| Część zapasowaNiższy znak wodnyPrzekroczony | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie SparePartitionLowWatermarkExceed. Oznacza to, że procent zużytego miejsca na dysku w zapasowej partycji przekroczył skonfigurowany znak niskiego poziomu wody. | Krytyczny |
| CoredUMPFileFound | Ten alert pojawia się podczas generowania zdarzenia CoreDumpFileFound. Oznacza to, że w systemie znaleziono plik zrzutu rdzenia. | Krytyczny |
| CCMENBłąd kryptograficzWykryto | Ten alert występuje, gdy wygenerowane jest zdarzenie CCMEncryptionErrorDetected. | Krytyczny |
| TCPremotesyslogDeliveryNie powiodło się | Ten alert pojawia się, gdy dostarczanie alarmów, audytów lub zdarzeń generowania rsyslog do skonfigurowanych zdalnych serwerów syslog nie powiedzie się. Powodem może być to, że skonfigurowany serwer syslog jest wyłączony lub TCP nie jest skonfigurowany na porcie 601 lub wystąpiła aw aria sieci. | Krytyczny |
| TLSremotesySLogDeliveryNie powiodło się | Ten alert pojawia się, gdy dostarczanie alarmów, audytów lub zdarzeń generowania rsyslog do skonfigurowanych zdalnych serwerów syslog nie powiedzie się. Powodem może być to, że skonfigurowany serwer syslog jest wyłączony, TLS przez TCP nie jest skonfigurowany na porcie 6514 lub wystąpiła awaria sieci lub certyfikat zdalnego serwera syslog mógł nie zostać przesłany do zaufania Tomcat. Unified CM | Krytyczny |
| UnreachableRemotesySLogServer | Ten alert pojawia się, gdy zdalny serwer syslog skonfigurowany dla usługi nie jest osiągalny. Powodem może być nieprawidłowy skonfigurowany serwer syslog lub gdy serwer syslog jest wyłączony lub gdy serwer syslog nie jest skonfigurowany do protokołów UDP/TCP/TLS dla portów 514/601/6514. | Powiadomienie |
| AuditloGoverflowDuetolPmPurge | Ten alarm wskazuje, że nastąpiło przepełnienie z powodu oczyszczenia przez logikę czyszczenia LPM. Gdy całkowite wykorzystanie miejsca na dysku partycji dziennika przekroczy skonfigurowany znak wysokiego poziomu wody, logika czyszczenia narzędzia LPM usuwa najstarsze pliki z partycji dziennika, dzięki czemu można zapisać nowe dzienniki. | Powiadomienie |
| UwierzytelnienieNiepowodzenie | Ten alert jest uruchamiany, gdy liczba zdarzeń AuthenticationFailed przekroczy (skonfigurowany) próg w (skonfigurowanym) przedziale czasu. To zdarzenie AuthenticationFailed występuje, gdy podczas próby logowania wystąpi błąd uwierzytelniania. | Powiadomienie |
| CałkowiteProcesy i WątkiSzecane Próg | Ten alert pojawia się, gdy generowane jest zdarzenie TotalProcessesAndThread SexceededThresholdStart. Oznacza to, że obecna całkowita liczba procesów i wątków przekroczyła maksymalną liczbę zadań skonfigurowanych dla parametru usługi Cisco RIS Data Col lector Service Parameter. Ta sytuacja może wskazywać na wyciek jakiegoś procesu lub w jakimś procesie wyciek nici. | Powiadomienie |
| LowActiveParctionDostępneDiskspace | Ten alert występuje, gdy procent dostępnego miejsca na dysku partycji aktywnej jest niższy niż skonfigurowana wartość. | Powiadomienie |
| LowInActivePartytionDostępneDiskspace | Ten alert występuje, gdy procent dostępnego miejsca na dysku partycji nieaktywnej jest niższy niż skonfigurowana wartość. | Powiadomienie |
| Niska wymiana partycjaDostępnemiejsce na dysku | Ten alert występuje, gdy procent dostępnego miejsca na dysku partycji zamiany jest niższy niż skonfigurowana wartość. | Powiadomienie |
| DBReplycation Failure | Ten alert występuje, gdy występują błędy replikacji bazy danych CallManager. | Powiadomienie |
| DBChangeNotifyFailure | Ten alert pojawia się, gdy usługa Cisco Database Notification Service na potka problemy i może zostać zatrzymana. Ten warunek oznacza zablokowanie żądań powiadomień o zmianie w kolejce w bazie danych, a zmiany wprowadzone w systemie nie wchodzą w życie . | Powiadomienie |
| Procesorowegowanie | Ten alert występuje, gdy procent obciążenia procesora serwera przekracza skonfigurowany procent dla skonfigurowanego okresu czasu. | Powiadomienie |
| LowAvailablePamięć wirtualna | Ten alert występuje, gdy procent dostępnej pamięci wirtualnej jest niższy niż skonfigurowana wartość. | Powiadomienie |
| CriticalServiceDown | Ten alert pojawia się, gdy stan operacyjny usługi jest NIEDOSTĘPNY. | Powiadomienie |
| ServerDown | Ten alert pojawia się, gdy węzeł zdalny jest nieosiągalny. | Powiadomienie |
| Wersja systemuNiedopasowana | Ten alert pojawia się, gdy występuje niedopasowanie wersji systemu. | Powiadomienie |
| Tabela DbReplicationOutOfSync | Ten alert jest uruchamiany, gdy wystąpią zdarzenia IDSReplicationFailure z numerem alarmu 888. Jedna lub więcej tabel może być niezsynchronizowana. Prosimy o kontakt Cisco TAC i zaplanuj konserwację. | Powiadomienie |
| Rejestracje kontrolneConfiguredThreshold | Ten alarm wskazuje, że procent miejsca na dysku skonfigurowanym do rejestrowania audytu aplikacji przekracza skonfigurowany próg. Pliki dzienników audytu zostaną zastąpione prędzej czy później w zależności od częstotliwości rejestrowania audytu przez aplikacje CUCM . | Powiadomienie |
| AudyloGoverflowDuetologRotation | Ten alarm wskazuje, że nastąpiło przepełnienie dziennika audytu. Istniejący plik dziennika audytu jest nadpisywany, co powoduje przepełnienie i ostateczną utratę danych audytu. | Powiadomienie |
| CiscohaproxyServiceDown | Ten alert pojawia się, gdy usługa Cisco HAProxy przestanie działać. | Powiadomienie |
| Wydarzenie SurvivabilityEvent | Ten alert pojawia się, gdy żaden z węzłów wystąpi Webex Calling enia dedykowanego nie jest osiągalny. | Krytyczny |
| RemoteSurvivabLenodenoTreachable | Ten alert występuje, gdy jeden lub więcej węzłów Remote Survi able nie jest osiągalnych dla węzłów Webex Calling dedykowanych instancji. | Krytyczny |
| CarSchedulerJobNie powiodło się | Ten alert pojawia się podczas generowania zdarzenia CarSchedulerJobFailed. Oznacza to, że zaplanowane zadanie CAR nie powiodło się. | Krytyczny |
| CARIDSSilnikKrytyczny | Ten alert pojawia się podczas generowania zdarzenia CARIDSEngineCritical. Ten alarm nie narusza danych ani nie uniemożliwia korzystania z systemu. | Krytyczny |
| CARIDSENGINEFailure | Ten alert pojawia się podczas generowania zdarzenia CARIDSEngineFailure. Jest to połączony alarm w sytuacjach awaryjnych i błędów. Wydarzyło się coś nieoczekiwanego , co może naruszyć dane lub dostęp do danych lub spowodować awarię identyfikatorów CAR IDS. | Krytyczny |
| CallAttemptBlockedByPolicy | Ten alert pojawia się, gdy generowane jest zdarzenie callAttemptBlockedByPolicy. Oznacza to, że wywołanie zostało podjęte próby, ale zablokowane lub odrzucone przez punkt decyzyjny polityki (PDP). | Krytyczny |
| EMCCFailedinLocalCluster | Ten alert występuje, gdy generowane jest zdarzenie EMCCFailedinLocalCluster. Oznacza to, że w lokalnym Menedżerze połączeń wystąpił błąd logowania EMCC. | Krytyczny |
| EMCCFailedinRemoteCluster | Ten alert występuje, gdy wygenerowane jest zdarzenie EMCCFailedinRemoteCluster. Oznacza to, że w zdalnym Menedżerze połączeń wystąpił błąd logowania EMCC. | Krytyczny |
| UserInputFailure | Ten alert występuje, gdy zostanie wygenerowane zdarzenie userInputFailure. Oznacza to, że wystąpiła niepowodzenie logowania do EMCC z powodu nieprawidłowego wprowadzenia danych użytkownika. | Krytyczny |
| Liczba zarejestrowanych urządzeń przekroczona | Ten alert pojawia się, gdy generowane jest zdarzenie NumDevRegExceed. | Krytyczny |
| CDragentsEndFileFailed | Ten alert pojawia się podczas generowania zdarzenia CDragentSendFileFailed. Oznacza to, że agent CDR nie może wysyłać plików CDR z węzła CCM do węzła repozytorium CDR w klastrze CCM. | Krytyczny |
| CDRFileDeliveryNie powiodła się | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie CDRFileDeliveryFailed. Oznacza to, że dostarczanie plików CDR przez FTP do zewnętrznego serwera rozliczeń nie powiodło się. | Krytyczny |
| CDRFileDeliveryFailureContinues | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie CDRFileDeliveryFailureContinues. Oznacza to, że dostarczanie plików CDR przez FTP na zewnętrzny serwer zdalny nie powiodło się po 3 lub więcej próbach. | Krytyczny |
| CDRHighWatermarkPrzekroczony | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie CDRHWMExceaded. Oznacza to, że osiągnięto High Water Mark dla plików CDR, niektóre pomyślnie dostarczone pliki CDR zostały usunięte. | Krytyczny |
| CDRMaximumDiskspace Exceed | Ten alert występuje, gdy zostanie wygenerowane zdarzenie CDRMaximumDiskSpaceExceaded. Oznacza to, że użycie dysku w plikach CDR przekroczyło maksymalny przydział dysku. Niektóre niedostarczone pliki zostały usunięte. | Krytyczny |
| ZłośliwyCallTrace | Ten alert pojawia się podczas generowania zdarzenia MaliciousCall. | Krytyczny |
| TCPSetupToimEfailed | Ten alert występuje, gdy wygenerowane jest zdarzenie TCPSetupToimeFailed. Ten alarm pojawia się, gdy Unified CM nie można nawiązać połączenia TCP z serwerem IME. Zwykle występuje, gdy adres IP i port serwera IME są nieprawidłowo skonfigurowane lub problem z łącznością intranetu uniemożliwia skonfiguro wanie połączenia. | Krytyczny |
| TLSConnectionToimefailed | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie TLSConnectionToimefailed. Nie można na wiązać połączenia TLS z serwerem IME z powodu problemu z certyfik atem prezentowanym przez serwer IME. (Na przykład nie jest w Unified CM CTL lub jest w CTL, ale wygasł). | Krytyczny |
| InvalidCredentials | Ten alert pojawia się podczas generowania zdarzenia InvalidCredentials. Po łączenie z serwerem IME nie mogło zostać zakończone, ponieważ nazwa użytkownika i/lub hasło skonfigurowane na serwerze IME Unified CM nie pasują do tych skonfigurowanych na serwerze IME | Krytyczny |
| ImeOverkwota | Ten alert pojawia się podczas generowania zdarzenia ImeOverquota. Każdy serwer IME ma ustalony limit całkowitej liczby DID, które może zapisać do rozproszonej pamięci podręcznej IME. Kiedy ten alarm jest generowany, oznacza to, że we wszystkich Unified CM klastrach korzystających z tego samego serwera IME limit dla rozproszonej pamięci podręcznej IME został przekroczony. | Krytyczny |
| IMEDistributedCacheNieaktywny | Ten alert pojawia się podczas generowania zdarzenia IMEdistributedCacheInactive. Ten alarm jest generowany podczas Unified CM próby połączenia z serwerem IME, jednak rozproszona pamięć podręczna IME nie jest obecnie aktywna | Krytyczny |
| Niewystarczające identyfikatory FallbackiDentifiers | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie InsuffentFallBackiDentifiers. Ten alarm jest generowany podczas Unified CM przetwarzania wywołania IME i próbuje przydzielić zastęp czy DID PSTN i sekwencję cyfr DTMF do skojarzenia z tym wywołaniem. Jednak obecnie w toku jest zbyt wiele wywołań IME, które wykorzystują ten sam zast ępczy DID, w wyniku czego nie ma już sekwencji cyfr DTMF, które mogłyby zostać przydzielone do tego wywołania. W związku z tym to połączenie będzie kontynuowane, jednak rezerwa w połowie połączenia nie będzie możliwa dla tego połączenia. | Krytyczny |
| SmartLicenseNeval | System działa w trybie ewaluacji, który wkrótce wygaśnie. | Krytyczny |
| SmartLicenseNoProvision_EvalExpired | Okres oceny licencji upłynął. | Krytyczny |
| SmartLicenseInOverage_AuthorizationExpired | Autoryzacja licencji wygasła. | Krytyczny |
| SmartLicenseNoProvision_AuthorizationExpired | Autoryzacja licencji wygasła. | Krytyczny |
| SmartLicenseRejestracjaWygasł | Rejestracja licencji wygasła, a system jest niezarejestrowany przez satelit Cisco Smart Software Manager ę | Krytyczny |
| SmartLicenseInOverage_OutOfCompliance | System działa z niewystarczającą liczbą licencji. | Krytyczny |
| SmartLicenseNoProvision_OutOfCompliance | System działa z niewystarczającą liczbą licencji. | Krytyczny |
| SmartLicenseBłąd komunikacjiBłąd | System nie mógł komunikować się z Cisco Smart Software Manager satelitą | Krytyczny |
| SmartLicenceRejestracjaWygasająca wkrótce | Rejestracja z satelitą Cisco Smart Software Manager lub wkrótce wygaśnie. | Krytyczny |
| SmartLicenseAutoryzacjaWygasająca wkrótce | Okres autoryzacji licencji wkrótce wygaśnie. | Krytyczny |
| SmartLicenceRenewAuthFailed | Odnowienie autoryzacji licencji nie powiodło się. | Krytyczny |
| SmartLicenceOdnowienieRejestracjaNie powiodło się | Odnowienie rejestracji licencji nie powiodło się. | Krytyczny |
| SmartLicenseKontrola eksportuNotAllowed | Ten Unified Communications Manager nie jest licencjonowany do pracy w trybie mieszanym | Krytyczny |
| SmartLicense_Reservation_InEval | Rezerwacja licencji jest włączona w tym systemie, a system działa w trybie ewal uacji, który wkrótce wygaśnie. | Krytyczny |
| SmartLicense_Reservation_NoProvision_EvalExpired | Rezerwacja licencji jest włączona w tym systemie i upłynął okres oceny licencji. | Krytyczny |
| SmartLicense_SLR_InOverage_NotAuthorized | Rezerwacja licencji jest włączona w tym systemie. Ten system działa z niewystarcz ającą liczbą licencji, a okres przekroczenia jest aktywny. | Krytyczny |
| SmartLicense_SLR_NoProvision_NotAuthorized | Rezerwacja licencji jest włączona w tym systemie. Ten system działa z niewystarcz ającą liczbą licencji, a okres przekroczenia upłynął. | Krytyczny |
| SmartLicense_Reservation_ExportControlNotAllowed | Rezerwacja licencji jest włączona, a ten system nie jest licencjonowany do pracy w trybie mieszanym. | Krytyczny |
| NierównośćAlert | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie IequalityAlertEntry. Ten alarm jest generowany, gdy znaczna liczba połączeń IME nie powiodła się z powrotem do PSTN lub nie Unified CM jest skonfigurowana z powodu problemów z jakością sieci IP. Istnieją dwa wyzwalacze tego alarmu. Jednym z nich jest sytuacja, gdy duża część aktualnie aktywnych połączeń IME ma wszystkie żądane awaryjne lub wróciły do PSTN. Drugim jest sytuacja, gdy duża część ostatnich prób połączeń nie została wykonana przez IP, a zamiast tego trafiła do PSTN. | Krytyczny |
| SmartLicenseKomunikacja | System nie nawiązał komunikacji za pomocą trybu Smart Transport, dlatego nadal będzie używać Call Home do komunikacji z satelitą Cisco Smart Software Manager lub satelitą. | Krytyczny |
| RouteListWyczerpane | Ten alert występuje, gdy liczba zdarzeń RouteListExhauted przekracza skonfigurowany próg w skonfigurowanym przedziale czasu. Oznacza to, że wszystkie dostępne kanały zdefiniowane na liście tras są zajęte. | Krytyczny |
| Nadmierna równość rachunkowaRaporty | Ten alert występuje, gdy liczba raportów jakości głosu przekracza skonfigurowany próg w skonfigurowanym przedziale czasowym. | Krytyczny |
| MedialistWyczerpany | Ten alert występuje, gdy liczba zdarzeń MediaResourceListExhauted przekracza skonfigurowany próg w skonfigurowanym przedziale czasu lub może wystąpić problem z konfiguracją. Oznacza to, że wszystkie dostępne zasoby multimedialne zdefiniowane na liście multimediów są zajęte lub że zasób medialny nie może zostać przydzielony. | Krytyczny |
| Strona głównaCalllistBlfSubscriptions | Ten alert pojawia się po wygenerowaniu zdarzenia beginThrottlingCallListBLFSubscriptions. Oznacza to, że zain Cisco CallManager icjowano ograniczenie subskrypcji CallList BLF w celu zapobieżenia przeciążeniu systemu. | Krytyczny |
| KodŻółty | Ten alert pojawia się podczas generowania zdarzenia Cisco CallManager CodeYellowEntry. | Krytyczny |
| SDLLinkOutOfService | Ten alert pojawia się podczas generowania zdarzenia SDLlinkoOS. To zdarzenie wskazuje, że lokal straci Cisco CallManager ł komunikację z pilotem Cisco CallManager. To zdarzenie zwykle wskazuje błędy sieciowe lub nieuruchomiony pilotCisco CallManager. | Krytyczny |
| RTMTSessionSexCeedsThreshold | Ten alert pojawia się, gdy liczba sesji RTMT przekroczy skonfigurowany próg. | Krytyczny |
| Liczba zarejestrowanych bram zwiększonych | Ten alert pojawia się, gdy liczba zarejestrowanych bram w klastrze wzrosła między kolejnymi sondażami. | Krytyczny |
| Liczba rejestrowanych bram zmniejszona | Ten alert pojawia się, gdy liczba zarejestrowanych bram w klastrze zmniejszyła się między kolejnymi sondażami. | Krytyczny |
| Liczba zarejestrowanych mediadevicesZwiększona | Ten alert pojawia się, gdy liczba zarejestrowanych urządzeń multimedialnych w klastrze wzrosła między kolejnymi ankietami. | Krytyczny |
| Zmniejszona liczba zarejestrowanych mediów | Ten alert pojawia się, gdy liczba zarejestrowanych urządzeń multimedialnych w klastrze zmniejszyła się między kolejnymi ankietami. | Krytyczny |
| Liczba zarejestrowanych telefonów usuniętych | Ten alert pojawia się, gdy liczba zarejestrowanych telefonów w klastrze spada o więcej niż skonfigurowany procent między kolejnymi ankietami. | Krytyczny |
| Przetwarzanie wywołaniaNodeCpugging | Ten alert występuje, gdy procent obciążenia procesora serwera przetwarzania połączeń przekracza skonfigurowany procent dla skonfigurowanego okresu czasu | Krytyczny |
| Zapobieganie blokom DDRBlock | Ten alert jest uruchamiany, gdy wystąpią zdarzenia IDSReplicationFailure z numerem alarmu 31. Wywołanie proaktywnej procedury w celu uniknięcia odmowy usługi. Ta procedura nie wpłynie na przetwarzanie połączeń. Podczas tego procesu zignoruj alarmy replikacji. Procedura trwa do 60 minut, sprawdź stan replikacji RTMT na 2 w każdym węźle, aby upewnić się, że procedura jest zakończona. Nie wykonuj ponownego uruchamiania systemu podczas tego procesu. | Krytyczny |
| DDRdown | Ten alert jest uruchamiany, gdy wystąpią zdarzenia IDSReplicationFailure z numerem alarmu 32. Procedura automatycznego odzyskiwania jest uruchomiona w tle i nie jest wymagane żadne działanie. Procedura trwa około 15 minut, sprawdź stan replikacji RTMT na 2 na każdym węźle, aby upewnić się, że procedura jest zakończona. | Krytyczny |
| MGCPDChannelOutOfUsługa | Ten alert pojawia się, gdy MGCP dChannel nie działa | Krytyczny |
| iService Status | Ten alert jest podnoszony, gdy wartość licznika iServicesStatus wynosi 2 = niezdrowe. Wskazuje to stan zdrowia tej instancji usługi IME. Wartość 0 oznacza nieznany status, co prawdopodobnie wskazuje, że usługa IME nie została aktywowana. Wartość 1 oznacza zdrowy: usługa IME została aktywowana i pomyślnie zakończono procedury uścisku dłoni z serwerem IME. Wartość 2 oznacza niezdrowe: usługa IME została aktywowana, ale nie zako ńczyła się pomyślnie procedur uścisku dłoni z serwerem IME. Należy pamiętać, że jeśli dodatkowy serwer IME jest skonfigurowany dla usługi IME, licznik ten odzwierciedla stan uścisku dłoni zarówno głównego, jak i dodatkowego serwera IME. | Krytyczny |
| LokalizacjaOutOfResource | Ten alert pojawia się podczas generowania zdarzenia LocationOutOfResource. Oznacza to, że jedna lub cała przepustowość audio lub wideo lub wciągająca dla lokalizacji lub łącza jest zużyta. | Krytyczny |
| Uwierzytelnianie ilstlsNie powiodło się | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie ILSTLSAuthenticationFailed. Nie można było nawiązać połączenia TLS ze zdalną usługą ILS z powodu problemu z certyfikatem prezentowanym przez zdalny klaster. (Na przykład nie jest w Unified CM CTL lub znajduje się w CTL, ale wygasł) Jeśli używasz certyfikatów tożsamości podpisanych przez CA bez wymiany certyfikatów, hasło musi być opat rzone w „Użyj certyfikatu TLS”. | Krytyczny |
| ILSPWDOwierzytelnianie nie powiodło się | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie ILSPWDAuthenticationFailed. Nie można nawiązać połączenia ze zdalną usługą ILS z powodu problemu z uwierzytelnianiem hasła w klastrze zdalnym. | Krytyczny |
| ILSHUBCLUSTERNieosiągalny | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie ILSHubclusterUnreachable. Nie można nawiązać połączenia ze zdalnym serwerem ILS. ILS będzie okresowo próbował ponownie połączyć się z klastrem koncentratorów. Jeśli stan jest spowodowany tymczas owym problemem z łącznością internetową, problem zostanie naprawiony samodzielnie. | Krytyczny |
| RejestracjaBramaRejestracjaOdrzucono | Ten alert pojawia się, gdy generowane jest zdarzenie RecordingGatewayRegistrationRejected. Rejestracja do bramy obsługującej nagrywanie odrzucona po wielu próbach . | Krytyczny |
| RejestracjaBramkaRejestracjaTimeout | Ten alert występuje, gdy generowane jest zdarzenie RecordingGatewayRegistrationTimeout. Brak odpowiedzi ze strony bramy obsługującej nagrywanie po wielu próbach; nastąpił limit czasu; brama oznaczona jako niedostępna | Krytyczny |
| RejestracjaZasoby niedostępne | Ten alert występuje, gdy generowane jest zdarzenie RecordingResourcesNotAvailable. Zasoby nośników nagrywania niedostępne (telefon lub bramka) | Krytyczny |
| RejestracjaBramtySesja nie powiodła się | Ten alert pojawia się, gdy generowane jest zdarzenie RecordingGatewaySessionFailed. Sesja nagrywania bramy zakończona nieoczekiwanie | Krytyczny |
| Nagrywanie CallSetupFail | Ten alert pojawia się, gdy generowane jest zdarzenie RecordingCallSetupFail. Zdarzenie jest wyzwalane, gdy konfiguracja nagrywania połączenia nie powiodła się lub zakończono czas żądania nagrywania do innego klastra | Krytyczny |
| RejestracjaSesja zakończonaNiespodziewanie | Ten alert pojawia się, gdy generowane jest zdarzenie RecordingsSessionTerminatedUnected. Zdarzenie jest uruchamiane, gdy sesja nagrywania zakończy się niespodziewanie | Krytyczny |
| ILSDuplicators | Ten alert pojawia się, gdy zostanie zidentyfi Cisco Unified Communications Manager kowany , że nauczył się zduplikowanych wpisów URI za pośrednictwem ILS podczas wywołania do identyfikatora URI. Za każdym razem, gdy dla identyfikatora URI są zduplikowane wpisy (takie jak identyfikator URI user@example.com istniejący w dwóch klastrach), wywołanie będzie zawsze kierowane do klastra, z którego identyfikator URI został po raz pierwszy wyuczony. Połączenia nie będą kierowane do innych zdu plikowanych wpisów. | Krytyczny |
| ILSPEERLIMITPodejście ostrzeżenia | Obecna liczba rówieśników osiągnęła 90% lub więcej przepustowości sieci ILS. | Krytyczny |
| ILSPEERLimitPrzekroczony | Liczba rówieśników dla tego klastra w sieci ILS jest większa niż ustawiony limitILSP_MSG_PEER_MAX. System będzie mógł stale dodawać szprychy, koncentratory i importowane katalogi; jednak tylko maksymalna liczba rówieśników będzie reklamowana w sieci ILS. | Krytyczny |
| Przełączniki i punkt dostępowy75 procent pojemności | Obecna liczba rekordów dla przełączników i punktów dostępu osiągnęła 75% maksymalnej pojemności 50000 rekordów. | Krytyczny |
| Przełączniki i punkt dostępowo uzyskiwano 90 procentów pojemności | Obecna liczba rekordów dla przełączników i punktów dostępu osiągnęła 90% maksymalnej pojemności 50000 rekordów. | Krytyczny |
| Przełączniki i punkt dostępowo poddany 95procentPojemność | Obecna liczba rekordów dla przełączników i punktów dostępowych osiągnęła 95% maksymalnej pojemności 50000 rekordów. | Krytyczny |
| CiscowLCSyncServiceDown | Przekroczono maksymalną liczbę urządzeń (50000) w przełącznikach i punktach dostępowych. | Krytyczny |
| LegacyCupClogina | Starszy Cisco Unified Personal Communicator klient próbował zalogować się do usługi Cisco Client Profile Agent | Krytyczny |
| InterClusterSyncAgentPeerDuplicate | Usługa Cisco Intercluster Sync Agent nie została zsynchronizowana ze zdalnym perem | Krytyczny |
| ICSACertifikatFingerPrintMismatch | Usługa Cisco Intercluster Sync Agent wykryła niedopasowanie odcisków palców na przetwarzanym certyfikacie | Krytyczny |
| ICSCertyfikataWalidationFailure | Usługa Cisco Intercluster Sync Agent wykryła błąd sprawdzania poprawności w przetwarz anym certyfikacie | Krytyczny |
| ICSAcertyfikowaneSyncConnectionOdmówiono | Usługa Cisco InterCluster Sync Agent Service wykryła błąd odmowy połączenia, ponieważ port 37239 nie był dostępny podczas przetwarzania certyfikatu. | Krytyczny |
| Certyfikat ICAcertyfikowaneTrust CertFound | Usługa Cisco Intercluster Sync Agent wykryła podpisany certyfikat zaufania certyfikatu certyfikatu | Krytyczny |
| Certyfikat ICAConflict | Usługa Cisco Intercluster Sync Agent wykryła konflikt certyfik atów CA | Krytyczny |
| ESPConfigAgentMemAllocError | Usługa Cisco Config Agent nie mogła przydzielić pamięci | Krytyczny |
| ESPConfigAgentFileWriteError | Usługa Cisco Config Agent nie mogła zapisać się do systemu plików | Krytyczny |
| ESPConfigAgentSharedMemorystaticRouteError | Usługa Cisco Config Agent nie mogła uzyskać dostępu do pamięci współdziel onej trasy statycznej | Krytyczny |
| ESPConfigAgentNetworkPrzerwa | Awaria sieci Cisco Config Agent | Krytyczny |
| ESPConfigAgentNetworkPrzywrócone | Przywrócono sieć agenta Cisco Config | Krytyczny |
| ESPConfigagEnhighMemoryUżycie | Wykorzystanie pamięci wirtualnej przekroczyło skonfigurowany próg | Krytyczny |
| ESPConfigagEnhighCPUWykorzystanie | Wykorzystanie procesora przekroczyło skonfigurowany próg | Krytyczny |
| ESPConfigAgentLocalDBAccessError | Usługa Cisco Config Agent nie mogła uzyskać dostępu do lokalnej bazy danych | Krytyczny |
| ESPConfigAgentRemotedBaccesError | Usługa Cisco Config Agent nie mogła uzyskać dostępu do zdalnej bazy danych wiadomości błyskawicznych i obecności | Krytyczny |
| ESPConfigAgentProxyDomainNotConfigurated | Usługa Cisco Config Agent wymaga skonfigurowania Domyślnej domeny wiadomości błyskawicznych | Krytyczny |
| PedataBaseError | Wyszukiwanie informacji nie powiodło się | Krytyczny |
| PepeerNodeFailure | Cisco Presence EngineUsługa w węźle równorzędnym podklastra nie powiodła się | Błąd |
| PEAutoRecoveryNie powiodło się | Cisco Presence Engineawaria automatycznego odzyskiwania usługi | Błąd |
| Znak wodnyHighWatermark | Wskazuje, Cisco Presence Engine że usługa przekroczyła próg wykorzystania procesora | Błąd |
| PEIDSTOIMDBDatabaseSyncerBłąd | Synchronizacja między bazą danych Cisco Unified CM IM i Presence a bazą danych Cisco Unified Presence Engine nie powiodła się | Błąd |
| PeidsSubscribeError | Cisco Presence EngineUsługa nie mogła subskrybować powiadomień o zmi Cisco Unified CM anie bazy danych wiadomości błyskawicznych i obecności | Błąd |
| PeidsqueryError | Cisco Presence EngineUsługa wykryła błąd podczas zapytania do bazy danych Cisco Unified CM IM i Presence | Błąd |
| PememoryHighCondition | Wskazuje, Cisco Presence Engine że usługa osiągnęła wysoki próg pamięci | Błąd |
| PesipPocketBindFailure | Cisco Presence Engineusługa nie mogła połączyć się z interfejsem słuchacza SIP | Błąd |
| PestateZablokowane | Cisco Presence EngineUsługa jest administracyjnie zabroniona przetwarzania ruchu | Błąd |
| PestateWyłączone | Cisco Presence Engineusługa nie działa i nie może przetwarzać ruchu | Błąd |
| PEWebDAVInitializationFailure | Cisco Presence Engineusługa próba włączenia biblioteki WebDAV nie powiodła się | Błąd |
| ESPZatrzymano | Cisco SIP Proxyproces obsługi dziecka został zatrzymany | Błąd |
| ESPsharedMemCreateZnaleziony | Nie udało się utworzyć pamięci współdzielonej | Błąd |
| ESPSharedMemSetPermNie powiodło się | Nie udało się ustawić uprawnień do pamięci współdzielonej | Błąd |
| ESPSharedMeAllocNie powiodło się | Nie udało się przydzielić pamięci współdzielonej | Błąd |
| ESPConfigerBłąd | Cisco SIP Proxybłąd pliku konfiguracji usługi | Błąd |
| ESPConfigNotFound | Cisco SIP ProxyNie znaleziono pliku konfiguracyjnego usługi | Błąd |
| ESPCreateLockFailed | Nie udało się utworzyć pliku blokady | Błąd |
| ESPSSocketBłąd | Wystąpiono błędy gniazda sieciowego | Błąd |
| ESPstatsLogFileOpenFailed | Nie udało się otworzyć pliku dziennika statystyk | Błąd |
| ESPmallocBłąd | Nie udało się przydzielić pamięci | Błąd |
| ESPWrongIpadSukienka | Podany nieprawidłowy adres IP | Błąd |
| ESPWrongNazwa hosta | Niewłaściwa nazwa hosta | Błąd |
| ESPPassedParaminNieprawidłowy | Określony nieprawidłowy parametr | Błąd |
| ESPNaptrInvalidRecord | Błąd formatu rekordu NAPTR | Błąd |
| ESPwirtualProxyError | Virtual_Proxy_Domainpowiązany błąd. | Błąd |
| EspregistryError | Błąd rejestru SIP | Błąd |
| Błąd esproutingowy | Błąd interfejsu trasy SIP | Błąd |
| EsploginError | Błąd logowania datastore | Błąd |
| UASCBFindFailed | SCB znajdzie awarię | Błąd |
| UASCBGetFailed | SCB uzyska lub tworzy awarię | Błąd |
| CTIGWModuleNotEnabled | Moduł aplikacji Cisco CTI Gateway nie jest skonfigurowany lub włączony | Błąd |
| CTIGWProviderDown | Dostawca CTI nie działa | Błąd |
| ctigwUserNie licencjonowany | Użytkownik nie ma licencji | Błąd |
| ctigwUserNotAuthorized | Użytkownik nieautoryzowany przez CTI Gateway | Błąd |
| CTIGWProviderNie udało się otworzyć | Nie udało się otworzyć CTI Provider | Błąd |
| CTIGWQBEFailedRequest | Błąd żądania QBE | Błąd |
| CTIGWSystemError | Błędy systemu aplikacji Cisco CTI Gateway | Błąd |
| PWSSCBFindNie powiodło się | SCB znajdzie awarię | Błąd |
| PWSSCbinitNie powiodło się | Awaria init SCB | Błąd |
| PWSABOVECPUlimit | Wskazuje, że Presence Web Service przekroczył próg wykorzystania procesora | Błąd |
| PWSrequestLimitOsiągnięty | Osiągnięto limit żądania usługi proxy na sekundę | Błąd |
| PWSABoveSIPSubscriptionLimit | Wskazuje, że liczba subskrypcji Presence Web Service przekroczyła maksymalny limit | Błąd |
| SyncAgentAXLConnectionNie powiodło się | Usługa Cisco Sync Agent nie powiodła się autoryzacji | Błąd |
| NotIncucmBłąd listy serwerów | Program Cisco Sync Agent nie uruchomił się z powodu braku węzła Cisco Unified CM IM i serwera obecności na liście serwerów Cisco Unified Communications Manager wydawcy. | Błąd |
| XCPTXTCONFDBConnecterROR | Warstwa dostępu do danych Cisco XCP nie mogła połączyć się z bazą danych. | Błąd |
| XCPDBConnector | Warstwa dostępu do danych Cisco XCP nie mogła połączyć się z bazą danych. | Błąd |
| XCPMessarchDBConnectError | Warstwa dostępu do danych Cisco XCP nie mogła połączyć się z bazą danych. | Błąd |
| XCPMFTDBConnector | Warstwa dostępu do danych Cisco XCP nie mogła połączyć się z bazą danych. | Błąd |
| XCPTXTCONFDBFullError | Warstwa dostępu do danych Cisco XCP nie była w stanie wstawić danych do bazy danych z powodu niewystarczającej ilości miejsca na dysku lub przestrzeni na tabelach. | Błąd |
| XCPMessarchDBFullError | Warstwa dostępu do danych Cisco XCP nie była w stanie wstawić danych do bazy danych z powodu niewystarczającej ilości miejsca na dysku lub przestrzeni na tabelach. | Błąd |
| XCPMFTDBFullBłąd | Warstwa dostępu do danych Cisco XCP nie była w stanie wstawić danych do bazy danych z powodu niewystarczającej ilości miejsca na dysku lub przestrzeni na tabelach. | Błąd |
| XCPCMComponent ConnectError | Nie udało się połączyć komponentu XCP z routerem XCP. Komponent się wyłącza. | Błąd |
| XCPWebcmComponentConnectError | Nie udało się połączyć komponentu XCP z routerem XCP. Komponent się wyłącza. | Błąd |
| XCPSipFedCmComponentConnectError | Nie udało się połączyć komponentu XCP z routerem XCP. Komponent się wyłącza. | Błąd |
| XCPXMPPFEDCMComponentConnectError | Nie udało się połączyć komponentu XCP z routerem XCP. Komponent się wyłącza. | Błąd |
| XCPTXTConfComponentBłąd konfiguracji | Składnik XCP wykrył nieprawidłową konfigurację. | Błąd |
| XCPMDNSStarTerror | Router XCP nie uruchomił MDNS. | Błąd |
| XCPComponentWriteAlarmyEllow | Jeden z komponentów IO routera XCP odnotował zwiększoną liczbę pakietów (ponad 50K). | Błąd |
| XCPComponentWriteAlarmoZmiany | Jeden z komponentów IO routera XCP odnotował zwiększoną liczbę pakietów (ponad 80K). Wkrótce może nastąpić upuszczenie pakietów! | Błąd |
| XCPComponentWriteAlarmRed | Jeden z komponentów IO routera XCP odnotował zwiększoną liczbę pakietów (ponad 100 tys.). Opuszczanie pakietów już teraz! | Błąd |
| XCPCMPAUSEkokiety | Router XCP skierował Menedżera połączeń XCP (CM), aby wstrzymał słuchanie w swoim gnieździe z powodu obciążenia systemu. | Błąd |
| XCPWebcmPauseSockets | Router XCP polecił Menedżerowi połączeń sieciowych XCP (CM), aby wstrzymał słuchanie w swoim gnieździe z powodu obciążenia systemu. | Błąd |
| XCPCMPAUSEkokiety | Router XCP skierował Menedżera połączeń XCP (CM), aby wstrzymał słuchanie w swoim gnieździe z powodu obciążenia systemu. | Błąd |
| XCPipFedCMPauseSockets | Router XCP skierował XCP SIP Federation Connection Manager (CM), aby wstrzymał słuchanie w swoim gnieździe z powodu obciążenia systemu. | Błąd |
| XCPXMPPFEDCMPAUSESockets | Router XCP skierował XCP XMPP Federation Connection Manager (CM), aby wstrzymał słuchanie w swoim gnieździe z powodu obciążenia systemu. | Błąd |
| XCPCMStartupBłąd | Uruchomienie usługi XCP Connection Manager nie powiodło się. | Błąd |
| XCPWebcmStartuperBłąd | Uruchomienie usługi XCP Web Connection Manager nie powiodło się. | Błąd |
| XCPipFedCmStartupBłąd | Uruchomienie usługi XCP SIP Federation Connection Manager nie powiodło się. | Błąd |
| XCPXMPPFEDCMStartuperBłąd | Uruchomienie usługi XCP XMPP Federation Connection Manager nie powiodło się. | Błąd |
| XCPWebcmHttpderbłąd | Usługa XCP Web Connection Manager zawiera błędy w interfejsie HTTP. | Błąd |
| xcpcmxmppderBłąd | Usługa XCP Connection Manager zawiera błędy w interfejsie XMPP. | Błąd |
| XCPCMPołączeniaPeripLimit | Liczba akceptowanych przychodzących połączeń klienta XMPP na adres IP osiągnęła maksymalny limit określony przez konfigurację. | Błąd |
| XCPWebcmPołączeniaLimit | Liczba akceptowanych przychodzących połączeń klientów WWW (BOSH) na adres IP osiągn ęła maksymalny limit określony przez konfigurację. | Błąd |
| XCPCMReadBytesLimit | Liczba bajtów odczytywanych z połączenia pojedynczego klienta osiągnęła maksymalny limit określony przez konfigurację. | Błąd |
| XCPWebcmReadBytesLimit | Liczba bajtów odczytywanych z połączenia pojedynczego klienta osiągnęła maksymalny limit określony przez konfigurację. | Błąd |
| XCpTxtConfgeaBłąd | Usługa XCP Text Conference Manager nie załadowała skonfigurowanego sprzętu. | Błąd |
| XCpTxtConfDBQueuESizeLimiterbłąd | Liczba żądań DB osiągnęła maksymalny limit określony przez konfigurację. | Błąd |
| xcptxtconftcWiadomościMSGideError | Nieprawidłowy stan tabeli tc_messages w zewnętrznej bazie danych używanej do stał ego czatu. | Błąd |
| XCPSIPGWStackResourceBłąd | Liczba jednoczesnych subskrypcji S2S SIP Federation lub call legs osiągnęła maksymalny limit określony w konfiguracji. | Błąd |
| XCPThirdPartyComplianceConnecterror | Cisco XCP Routernie może połączyć się z serwerem zgodności stron trzecich | Błąd |
| XCPConfigMGRjabberRestartRequed | Cisco XCP Config Manager zregenerował pliki JabberXML po zatrzy maniu systemu ze względu na rozmiar bufora. Router XCP musi zostać ponownie uruchomiony, aby odebrać zmiany. | Błąd |
| XCPConfigMGRKonfiguracjaBłąd | Program Cisco XCP Config Manager nie może wysłać konfiguracji do komponentu. Proszę sprawdzić dzienniki. | Błąd |
| XCPConfigMGRhostNameResolucijaNie powiodło się | Rozwiązanie nazwy hosta XCP Config Manager nie powiodło się | Błąd |
| XCPConfigMGRR2RHasłoKryptionNie powiodło się | Szyfrowanie hasła XCP Config Manager nie powiodło się | Błąd |
| XCPConfigMGRR2RRequestTimedOut | Żądanie konfiguracji XCP Config Manager R2R upłynęło | Błąd |
| XCPMfTextFSMounterror | Cisco XCP File Transfer Manager stracił połączenie z zewnętrznym serwerem plików. | Ostrzeżenie |
| XCPMfTextfsFreeSpaceOstrzeż | Program Cisco XCP File Transfer Manager wykrył, że wolne miejsce na dysku na zewnętrznym serwerze plików jest mało. | Ostrzeżenie |
| SRMFailover | Cisco SRM wykonuje automatyczne przełączanie awaryjne | Ostrzeżenie |
| srmNie powiodło się | Cisco Server Recovery Managerjest w stanie nieudanym | Ostrzeżenie |
| ReplikacjaIMAddressSchemeChangeFailure | Ten alert pojawia się, gdy zmiana schematu adresów wiadomości błyskawicznych nie powiedzie się. | Ostrzeżenie |
| ReplicationDefaultimDomainChangeFailure | Ten alert pojawia się, gdy domyślna lokalna zmiana domeny wiadomości błyskawicznych nie powiedzie się. | Ostrzeżenie |
| DuplicateUserId | Cisco IM i Presence Data Monitor wykryły, że dwóch lub więcej użytkowników w systemie ma tę samą wartość identyfikatora użytkownika. | Ostrzeżenie |
| DuplicateDirectorYuri | Cisco IM i Presence Data Monitor wykryły, że dwóch lub więcej użytkowników w systemie ma tę samą wartość identyfikatora URI katalogu. | Ostrzeżenie |
| InvalidDirectorYuri | Program Cisco IM i Presence Data Monitor wykrył, że jeden lub więcej użytkowników ma nieprawidł ową wartość identyfikatora URI katalogu. | Ostrzeżenie |
| JSMSessionSexCeedsThreshold | Ten alert występuje, gdy liczba sesji JSM przekracza skonfigurowany próg maksymalnej sesji zdefiniowany przez szablon OVA. Więcej informacji na temat maksymalnego limitu sesji zdefiniowanego dla szablonu OVA można znaleźć w sekcji Przewodnik dotyczący konfiguracji i administracji wiadomości błyskawicznych oraz obecności — Monitorowanie pojemności urządzeń. | Ostrzeżenie |
| NoConnectionToPeer | Ten alert pojawia się podczas generowania zdarzenia NoConnectionToPeer. Oznacza to utratę połączenia z serwerem równorzędnym. | Ostrzeżenie |
| AutofailoverSuccessful | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie AutoFailOverSucceed. Oznacza to, że automatyczne przełączanie awaryjne zostało pomyślnie wykonane. | Ostrzeżenie |
| AutofailOverFailNie powiodło się | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie AutoFailOverFailed. Oznacza to, że bezskutecznie podjęto próbę automatycznego przełączania awaryjnego. | Ostrzeżenie |
| AutoFailBackUded | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie AutoFailBackSucceed. Oznacza to, że automatyczna awaryjność została pomyślnie wykonana. | Ostrzeżenie |
| AutofailBackNie powiodło się | Ten alert pojawia się, gdy zostanie wygenerowane zdarzenie AutoFailBackFailed. Oznacza to, że automatyczne awarie zostało zautomatyzowane bezskutecznie. | Ostrzeżenie |
| SBRnie powiodło się | Ten alert pojawia się po wygenerowaniu zdarzenia SBRFailed. Oznacza to, że automatycznie wywoływ ana procedura rozdzielania dzielonego mózgu zwróciła błąd. | Ostrzeżenie |
| Zużycie dyskuCloseToCapacityThreshold | Zużycie miejsca na dysku jest zbliżone do progu pojemności dysku określonego na stronie Ustawienia systemowe > Zaawansowane > Pojemność dysku w Cisco Unity Connection Administracji. System nie będzie rejestrować nowych wiadomości, jeśli zużycie dysku osiągnie próg. | Ostrzeżenie |
| Zużycie dyskuPrzekroczeniePróg pojemnościowy | Zużycie miejsca na dysku osiągnęło próg pojemności dysku zdefiniowany na stronie Ustawienia systemowe > Zaawansowane > Pojemność dysku w Cisco Unity Connection Administracji. System nie będzie rejestrować nowych wiadomości, gdy zużycie dysku jest wyższe lub wyższe niż próg. | Ostrzeżenie |
| LicencjaWygasnąOstrzeżenie | Niewystarczające naruszenie licencji trwało po okresie karencji. Działanie systemu zostanie zawieszone. Aby uzyskać szczegółowe informacje, zobacz stronę licencji w Cisco Unity Connection Administracji dotyczącej połączenia Unity i korzystania z licencji w Enterprise License Manager administracji. Zmniejsz użycie, aby dopasować licencjonowane limity programu Enterprise Licensing Manager lub zakupić dodatkowe licencjonowane funkcje. Gdy system będzie ponownie zgodny, konieczne będzie ręczne ponowne uruchomienie systemu, aby przywrócić działanie systemu. | Ostrzeżenie |
| Ostrzeżenie o naruszeniu licencji | Doszło do niewystarczającego naruszenia licencji. Aby uzyskać szczegółowe informacje, otwórz ekran Użycie licencji na stronach Enterprise License Manager administracyjnych. Jeśli naruszenie licencji będzie kontynuowane po okresie karencji, operacje systemu zostaną zawieszone. | Ostrzeżenie |
| ElmnotZłączony | Łączność z Enterprise License Manager serwerem jest przerwana. Jeśli łączność zostanie utracona poza okresem karencji, operacje systemu zostaną zawieszone. | Ostrzeżenie |
| BranchProvisioned | Oddział związany z połączeniem centralnej jedności został pomyślnie zaopat rzony. | Ostrzeżenie |
| DBalmostPełny | DBspace jest prawie pełny. Jeśli DBspace zostanie zapełniony, system może nie być w stanie zapewnić wszystkich usług. | Ostrzeżenie |
| BranchProvisioningFailed | Przydzielanie gałęzi powiązanej z połączeniem centralnej jednostki nie powiodło się. | Ostrzeżenie |
| BranchProvisioningFailedMaxWait | Prowizjonowanie oddziału nie powiodło się z powodu maksymalnego czasu oczekiwania na odpowiedź na zakończenie zaopatrzenia z oddziału. | Ostrzeżenie |
| BranchProvisioningFailedMaxRetries | Przydzielanie gałęzi powiązanej z połączeniem centralnym nie powiodło się we wszystkich ponownych próbach. | Ostrzeżenie |
| BranchNotReachable | Łączność między centralnym a oddziałem jest zerwana. | Ostrzeżenie |
| CentralNotreachable | Łączność między oddziałem a centralnym biurem jest zerwana. | Ostrzeżenie |
| EVTReaderDirectoryException | Synchronizacja katalogów napotkała wewnętrzny błąd przetwarzania. | Ostrzeżenie |
| EVtReaderRetryQueuegettingPełny | Podczas przetwarzania zmian w obiekcie Reader nie zastosował tych zmian i umie ścił je w kolejce ponownej próby. Ta kolejka jest teraz pełna. | Ostrzeżenie |
| EVTERRozłączony | Ten alert pojawia się, gdy alarm ER Disconnect jest podniesiony przez informix. | Ostrzeżenie |
| VoiceNameReaderPublisherOnly | Ta instancja zadania synchronizacji nazw głosu nie została uruchomiona, ponieważ została uruchomiona na komputerze subskrybentowym klastra. | Ostrzeżenie |
| NazwaGłosoczytelnikaNotFound | Zadanie synchronizacji wymaga informacji o łączu lokalizacji zdalnej w celu synchronizacji, ale nie udało się znaleźć informacji w bazie danych. | Ostrzeżenie |
| Nazwa głosu ReaderException | Synchronizacja nazw głosu napotkała wewnętrzny błąd przetwarzania. | Ostrzeżenie |
| CzytelnikNotFound | Zadanie synchronizacji wymaga informacji o łączu lokalizacji zdalnej w celu synchronizacji, ale nie udało się znaleźć informacji w bazie danych. | Ostrzeżenie |
| ReaderPublisher Only | Ta instancja zadania synchronizacji katalogów nie została uruchomiona, ponieważ została uruchomiona na subskrybującym członku klastra. | Ostrzeżenie |
| CzytnikNetworkLoop Detected | Podczas przetwarzania zmian obiektu Reader nie zastosował tych zmian, ponieważ wykrył pętlę sieciową. | Ostrzeżenie |
| ReaderDirectoryNOSMTPDomain | Domena SMTP jest niezbędna do adresowania i przesyłania wiadomości między lokalizacjami. Synchronizacja nie będzie możliwa, dopóki domena SMTP nie zostanie skonfigurowana w zdalnej witrynie/lokalizacji. | Ostrzeżenie |
| ReaderDirectoryFeedAccessError | Intersite BridgeHead/HTTP (S) location object feed zawiera informacje o katalogach niezbędne do umożliwienia adresowania wiadomości do użytkowników w zdalnych witrynach/lokalizacjach. Błąd podczas pobierania danych obiektów uniemożliwia pełną synchronizację ze zdalną lokalizacją/lokalizacją. | Ostrzeżenie |
| ReaderInfoFeederError | Zadanie synchronizacji próbuje pobrać status zdalnej strony/ lokalizacji, ale ta informacja o stanie nie była obecnie dostępna. | Ostrzeżenie |
| NetworkRemoverFault | Odłącza do lokalizacji zdalnej nie można usunąć, ponieważ wszystkie obiekty zsynchronizowane z witryną zdalną nie zostały usunięte. | Informacyjny |
| Usuwanie sieci Błąd | W zadaniu „Usuń obiekty powiązane z usuniętymi witrynami zdalnymi” wystąpił błąd . Może to być wynikiem innych działań w systemie. Następne uruchomienie zadania może nie napotkać tego samego problemu. | Informacyjny |
| EvtreaderDirectoryOverflow | Liczba obiektów katalogów w tej lokalizacji przekroczyła obsługiwany limit. | Informacyjny |
| KatalogSynchronizacjaAlertMode | Lokalizacja HTTP (S) Komputer wydawcy jest obecnie niedostępny, chociaż synchronizacja katalogów odbywa się z komputerem subskrybentów. | Informacyjny |
Reguła alarmu zdarzenia anomalii oparta na sztucznej inteligencji
Ta reguła służy do otrzymywania alertów opartych na sztucznej inteligencji w przypadku scenariuszy usług aplikacji UC, takich jak anomalia związane z spadkami rejestracji, głośnością połączeń i awariami połączeń.
Jak utworzyć regułę
- Zaloguj się do Control Hub i przejdź do Po wiadomienia > Moje reguły.
- Kliknij opcję Utwórz regułę.
- W sekcji Pod sumowanie skonfiguruj regułę alertów aplikacji UC.
- Z listy Usługa wybierz opcję Dzw onienie.
- Z listy Typ wybierz Zdar zenia anomalii oparte na sztucznej inteligencji w chmurze.
- Wybierz preferowaną dot kliwość.
- To pole pokazuje, jak poważny lub ważny jest alarm. Możesz wybrać poziom nasilenia jako Wyso ki, Śred ni lub Niski.
- Zapoznaj się z sekcją Tabela ciężkości, aby dowiedzieć się więcej na temat koncentratora sterowania i nasilenia typu alertu.
- Zapoznaj się z tabelą listy anomalii AI, aby dowiedzieć się więcej na temat różnych nazw alertu, opisu i poziomu nasilenia.
- Wprowadź tytuł nowej reguły i sprawdź, czy przełącznik alertów jest włącz ony.
- Sprawdź, czy przełącznik alertów jest WŁĄCZ ONY, aby otrzymywać powiadomienia dotyczące
alertu.
Po wyłączeniu użytkownicy nie otrzymają alertów.
- W sekcji Cel wybierz co najmniej jeden klaster aplikacji Cisco Unified Call Manager, aby otrzymywać powiadomienia o anomaliach opartych na sztucznej inteligencji.
- W sekcji Definicja reguł ut wórz regułę, aby otrzymywać powiadomienia o wykrytych przez sztuczną inteligencję
anomaliach podczas połączeń i czynności związanych z rejestracją telefoniczną. Wybierz zdarzenia dla wybranego
klastra aplikacji UC, które chcesz monitorować. Wydarzenia są
- Awarie połączeń — otrzymywanie powiadomień o anomaliach awarii połączeń wykrytych na podstawie prognozowanych danych, w tym nieoczekiwanych skoków awarii połączeń.
- Głoś ność połączeń — otrzymywanie powiadomień o anomaliach awarii połączeń wykrytych w oparciu o przewidywane dane, w tym nieoczekiwane skoki awarii połączeń.
- Zrzut rejestracji telefonicznej - Otrzymuj powiadomienia o anomaliach spadku rejestracji telefonu wykrytych w klastrach i puli urządzeń w oparciu o prognozowane dane.
- W sekcji Kanał dostawy wybierz sposób otrzymywania alertów:
- E-mail— Wprowadź adresy e-mail osób, które otrzymają alerty.
- Webex space— Wprowadź nazwę pomieszczenia, aby otrzymać alert jako wiadomości w sp
acji. Bot wysyła wiadomości tylko do odbiorców, którzy są dodawani do kanału dostarczania wiadomości e-mail.
Aby aplikacja Webex mogła używać przestrzeni jako kanału dostawy, Twoja organizacja musi mieć włączoną obsługę wiadomości.
- Webhook— zaz nacz to pole wyboru, jeśli chcesz używać alertu z aplikacjami innych firm.
- Kliknij przycisk Zapisz.
Po utworzeniu reguł rozpoczęcie otrzymywania powiadomień zajmuje maksymalnie 6 godzin.
W przypadku urządzeń można utworzyć reguły, aby otrzymywać alerty dotyczące:
- Wydar@@ zenia offline i online — Zdarzenie jest rejestrowane po tym, jak urządzenie było offline przez 5 minut lub wróciło do trybu online 5 minut temu. Możesz utworzyć do 100 takich alertów.
- Problemy wykryte lub rozwiązane zdarzenia — możesz wybrać, czy chcesz otrzymywać wszystkie alerty, czy wyciszyć te, których nie chcesz otrzymywać. Możesz utworzyć do 100 takich alertów.
- Wygaśnięcie wersji oprogramowania — Alert jest wysyłany na 14 dni i 3 dni przed wygaśnięciem wersji oprogramowania dla urządzenia. Możesz utworzyć do 10 takich alertów
Alerty o telefonach PhoneOS w Control Hub
Jako administrator możesz sprawdzić stan telefonów, które są zarejestrowaneWebex Calling. Jeśli w telefonie wystąpi jakikolwiek problem, szczegóły można zobaczyć w sekcji Problemy i informacje w sekcji Urzą dzenia do diagnostyki i rozwiązywania problemów.
Możesz także wyświetlić wszystkie alerty zgłaszane przez telefon w Po wiadomieniach. Aby uzyskać więcej informacji na temat powiadomień, zobacz Powiadomienia w centrum sterowania.
Protokół połączenia
| Nazwa wyświetlacza | Kod | Typ | Wiadomość | Poziom |
|---|---|---|---|---|
| Ograniczona obsługa | wxclimitedservice | Ograniczona obsługa | Tryb SRST - ten telefon ma ograniczoną obsługę.
Wiadomość może być również wyświetlana na ekranie telefonu. | Ostrzeżenie |
| Rejestracja profilu Sip | SipProfileRejestracja | Rejestracja SIP nieudana | Rejestracja SIP nieudana | Błąd |
Sieć
| Nazwa wyświetlacza | Kod | Typ | Wiadomość | Poziom |
|---|---|---|---|---|
| Wykryto utratę pakietów | jakość sieci | Wykryto utratę pakietów | Podczas ostatniego połączenia wykryliśmy poziom utraty pakietów, który mógł wpłynąć na jakość połączenia. Utrata pakietów jest zwykle spowodowana przeciążeniem sieci. | Ostrzeżenie |
Przycisk akcji
| Nazwa wyświetlacza | Kod | Typ | Wiadomość | Poziom |
|---|---|---|---|---|
| Przycisk akcji nie jest skonfigurowany | actionbuttonnotconfig | Przycisk akcji nie jest skonfigurowany | Przycisk Action nie jest skonfigurowany. Skonfiguruj go we wszystkich konfiguracjach > Telefon > Przycisk akcji. | Ostrzeżenie |
| Przycisk akcji serwis awaryjny niedostępny | awaryjnyniedostępne | Przycisk akcji serwis awaryjny niedostępny | Dostęp do służby ratunkowej jest niemożliwy, ponieważ żadna linia nie jest zarejestrowana. Nie będzie można użyć przycisku Akcja ani wybierać numerów, aby uzyskać dostęp do usługi. | Ostrzeżenie |
Zabezpieczenia
| Nazwa wyświetlacza | Kod | Typ | Wiadomość | Poziom |
|---|---|---|---|---|
| Rejestrowanie certyfikatu SCEP nie powiodło się | scepcertenrollmentfailed | Rejestrowanie certyfikatu SCEP nie powiodło się | Rejestrowanie certyfikatu SCEP nie powiodło się | Błąd |
Konfiguracja
| Nazwa wyświetlacza | Kod | Typ | Wiadomość | Poziom |
|---|---|---|---|---|
| Nie udało się zastosować zmian konfiguracyjnych | wxcresyncfailed | Nie udało się zastosować zmian konfiguracyjnych | Telefon nie zastosował zmian konfiguracyjnych. Konfiguracje mogą być nieaktualne. | Błąd |
| Aktualizacja nie powiodła się | wxcupgradefailed | Aktualizacja nie powiodła się | Telefon nie zaktualizował oprogramowania układowego. Sprawdź, czy urządzenie ma działające połączenie sieciowe, czy DNS jest skonfigurowany i nie jest blokowany przez zapory ogniowe lub serwery proxy. | Błąd |
Użyj powiadomień Agent Central w Centrum sterowania, aby przejrzeć zmiany serwera i funkcji Agentic Apps, które mogą mieć wpływ na dostęp organizacji. Powiadomienia Agent Central pojawiają się, gdy włączony publiczny lub prywatny serwer Agentic Apps zmienia się w sposób wymagający świadomości administratora lub przeglądu.
Musisz być administratorem Centrum sterowania z dostępem do powiadomień, aby wyświetlać alerty Agent Central dla aplikacji Agentic i zarządzać regułą dostarczania generowanych alertów.
W Centrum sterowania alerty Agentic Apps i wygenerowane reguły są wyświetlane z nazwą Agent Central. Wyszukaj Agent Central podczas filtrowania alertów lub reguł.
Wszystkie alerty Agent Central dla aplikacji Agentic są wyświetlane w Centrum sterowania. Alerty zablokowane o wysokiej nasileniu mogą być również dostarczane pocztą elektroniczną lub do przestrzeni aplikacji Webex podczas konfigurowania dostawy dla wygenerowanej reguły. Alerty ostrzegawcze o niskim stopniu nasilenia są wyświetlane tylko w Powiadomieniach.
Powtarzające się wykrywanie tej samej nierozwiązanej zmiany nie generuje zduplikowanych alertów. Jeśli problem zostanie usunięty, a serwer zmieni się ponownie później, Control Hub utworzy nowy alert dotyczący nowej zmiany.
Wyświetlanie alertów Agent Central dla aplikacji Agentic
Musisz być administratorem Control Hub z dostępem do powiadomień.
| 1 |
Zaloguj się do Control Hub. |
| 2 |
Przejdź do Po wiadomienia > Alerty. |
| 3 |
Wybierz opcję Wszystkie alerty, aby wyświetlić alerty dla Twojej organizacji, lub Moje alerty, aby wyświetlić alerty dostarczone do Ciebie. |
| 4 |
Użyj wyszukiwania lub filtrów, aby znaleźć alerty Agent Central. |
| 5 |
Wybierz wiersz alertu, aby wyświetlić szczegóły alertu, lub wybierz opcję Przeglądaj serwer, aby otworzyć serwer Agentic Apps, którego dotyczy problem. |
Typy ostrzeżeń Agent Central
Alerty Agent Central dla aplikacji Agentic informują, czy dostęp może być kontynuowany z ostrzeżeniem, czy też jest zablokowany, dopóki administrator nie przejrzy zmiany.
| Typ alertu | Poważność | Co to znaczy | Co robić |
|---|---|---|---|
| Ostrzeżenie dotyczące komunikacji metadanych | Niski | Zmieniono nazwę serwera, opis lub adres URL tej samej domeny, a dostęp może być kontynuowany do czasu przeglądu. | Przejrzyj serwer i ponownie zatwierdź metadane lub wyłącz serwer, jeśli nie ufasz zmianie. |
| Komunikacja metadanych zablokowana | Wysoki | Zmiana na poziomie serwera blokuje dostęp. Może to obejmować nową domenę adresu URL, zablokowaną zmianę metadanych, zabezpieczenia karty agenta lub zmiany interfejsu lub nieprawidłową plakietkę serwera. | Przejrzyj i ponownie zatwierdź serwer, postępuj zgodnie ze wskazówkami na stronie serwera w przypadku problemów z odznakami lub wyłącz serwer. |
| Ostrzeżenie o możliwości komunikacji | Niski | Zmieniono włączone narzędzie, monit, zasób lub umiejętność, a Twoja organizacja umożliwia kontynuowanie dostępu do czasu przeglądu. | Przejrzyj i ponownie zatwierdź dotkniętą funkcję lub wyłącz ją. |
| Zablokowana komunikacja z możliwościami | Wysoki | Zmieniono włączone narzędzie, monit, zasób lub umiejętność, a organizacja nie zezwala na kontynuowanie dostępu lub włączony element został usunięty lub zmieniony. Dostęp do przedmiotu, którego dotyczy problem, jest zablokowany. | Przejrzyj i ponownie zatwierdź dotknięte funkcje lub wyłącz przedmioty, których dotyczy problem. |
Jeśli to samo odświeżenie wykryje zarówno zmiany ostrzeżenia, jak i zablokowane możliwości, Control Hub wyświetli jeden alarm zablokowany o wysokiej intensywności, z obydwoma stanami wymienionymi w szczegółach alertu. Na przykład alarm zablokowany może zawierać dwa narzędzia ze statusem Zablokowany i jeden monit z ostrzeżeniem o stanie.
Zarejestrowane serwery nie generują alertów Agent Central, dopóki nie zostaną zatwierdzone i włączone dla Twojej organizacji. Nowe narzędzia, monity, zasoby lub umiejętności, które nie zostały włączone w organizacji, nie uruchamiają alertów Agent Central.
Przeglądaj i rozwiązuj alerty Agent Central
Użyj serwera przeglądu z alertu, aby sprawdzić serwer lub funkcję Agentic Apps, którego dotyczy problem.
| 1 |
Zaloguj się do Control Hub. |
| 2 |
Przejdź do Po wiadomienia > Alerty. |
| 3 |
Wyszukaj Agent Central. |
| 4 |
Otwórz alert, który chcesz przejrzeć. |
| 5 |
Wybierz opcję Przeglądaj serwer. |
| 6 |
Przejrzyj metadane serwera, narzędzie, monit, zasób lub umiejętności, których dotyczy problem. |
| 7 |
Wybierz jedną z tych działań:
|
Control Hub usuwa aktywny alert po poprawieniu, wyłączeniu lub ponownym zatwierdzeniu problemu. Ręczne zaznaczenie wiersza Centrum ostrzeżeń jako rozwiązanego nie powoduje zatwierdzania metadanych, przywracania plakietki ani odblokowywania dotkniętej funkcji. Jeśli problem podstawowy nadal występuje, Control Hub może utworzyć nowy alert, gdy ponownie wykryje nierozwiązaną zmianę.
Wyświetl reguły alertów Agent Central
Reguły alertów Agent Central dla aplikacji Agentic są automatycznie generowane przez Webex i pojawiają się w usłudze Ogólne. Te wygenerowane reguły są tylko do odczytu dla nazwy reguły, dotkliwości, usługi i warunków wyzwalania. W przypadku reguł zablokowanych o dużej surowości można skonfigurować kanały dostawy i odbiorców.
| 1 |
Zaloguj się do Control Hub. |
| 2 |
Przejdź do Po wiadomienia > Alerty. |
| 3 |
Wybierz opcję Wszystkie reguły. |
| 4 |
Wyszukaj Agent Central. |
Konfigurowanie dostawy dla alertów Agent Central o wysokiej intensywności
Alerty zablokowane o wysokiej nasileniu mogą być dostarczane pocztą elektroniczną lub do przestrzeni aplikacji Webex. Control Hub zawsze otrzymuje alert, nawet jeśli nie dodasz adresata wiadomości e-mail lub aplikacji Webex.
| 1 |
Zaloguj się do Control Hub. |
| 2 |
Przejdź do Po wiadomienia > Alerty. |
| 3 |
Wybierz opcję Wszystkie reguły. |
| 4 |
Wyszukaj Agent Central. |
| 5 |
Otwórz jedną z reguł zablokowanych o dużej surowości: zablokowana komunikacja metadanych Agent Central lub zablo kowana komunikacja z funkcjami Agent Central. |
| 6 |
W kanale dostawy wybierz opcję E-mail i dodaj odbiorców wiadomości e-mail. |
| 7 |
Aby wysyłać alerty w przestrzeni aplikacji Webex, wybierz przestrzeń Webex i wybierz opcję dostarczania przestrzeni. |
| 8 |
Zapisz regułę. |
Uwagi i ograniczenia dotyczące powiadomień Agent Central
Pamiętaj o tych notatkach i ograniczeniach podczas korzystania z powiadomień Agent Central dla aplikacji Agentic.
- Alerty Agentic Apps są wyświetlane z nazwą Agent Central w Centrum sterowania.
- Alerty ostrzegawcze o niskiej nasileniu są przeznaczone wyłącznie do Centrum ostrzeżeń.
- Alerty zablokowane o wysokiej nasileniu mogą być dostarczane pocztą elektroniczną lub przestrzenią aplikacji Webex, jeśli dostawa jest skonfigurowana na wygenerowanej regułie.
- Zarejestrowane, ale niewłączone serwery nie generują alertów Agent Central.
- Nowe funkcje poprzedzające, które nie zostały włączone dla Twojej organizacji, nie powodują powiadomień Agent Central.
- Powtarzające się wykrywanie tej samej nierozwiązanej zmiany nie powoduje powstawania zduplikowanych alertów.
- Alerty serwera publicznego są przekazywane do każdej organizacji, której dotyczy problem.
- Alerty serwera prywatnego są przekazywane do organizacji będącej właścicielem po zatwierdzeniu i włączeniu serwera.
- Gdy problem z metadanymi na poziomie serwera blokuje dostęp, Centrum sterowania może wyświetlać alert zablokowany metadane zamiast oddzielnych alertów o możliwości, dopóki problem na poziomie serwera nie zostanie rozwiązany.
Możesz skonfigurować adres URL wywołania zwrotnego webhook, aby alerty pojawiały się w aplikacjach innych firm. Administrator może określić adres URL wywołania zwrotnego webhook w Centrum sterowania. Po podaniu adresu URL wywołania zwrotnego możesz wybrać opcję webhook jako dodatkowy kanał dostawy w regułach dla nowych lub istniejących alertów. Poniżej znajdują się kroki, jak skonfigurować webhooky.
Oto przykład tego, jak wygląda element JSON dla webhook alertu:
{
"orgId": "1ab23cde-4567-890f-1234-gh56ijk07l891",
"title": "title",
"summary" : "notification for a test alert",
"actionUrl" : "www.actionURL.com",
"severity" : "HIGH",
"eventType" : "created",
"resourceType": "ControlHubAlerts",
"type": "Meeting",
"subtype": "Live Meeting Monitoring",
}
Konfigurowanie adresu URL wywołania zwrotnego webhook
Najpierw musisz dodać adres URL wywołania zwrotnego webhook, zanim będzie można włączyć reguły korzystania z webhooków.
| 1 |
Zaloguj się do Control Hub i przejdź do Ustawienia organizacji. |
| 2 |
Przewiń do sekcji konfiguracji Webhook. |
| 3 |
Przełącz przełącznik Kon figuruj adres URL haczyka na włączony. Pojawi się wyskakujące okienko. |
| 4 |
Wprowadź adres URL webhook, którego chcesz użyć. Możesz także dodać tajny token do haczyka internetowego. Zobacz ten blog, aby dowiedzieć się więcej o tajnych tokenach. 
|
| 5 |
Wybierz Sprawdź poprawność. Jeśli walidacja nie powiedzie się, sprawdź, czy adres URL webhook i tajny token są poprawne. Kliknij S próbuj ponownie po zakończeniu sprawdzania. |
| 6 |
Wybierz Zapisz. |
Włącz webhook w regułach
Po skonfigurowaniu adresu URL webhook, możesz skonfigurować reguły, aby używać webhooków jako kanału dostawy.
| 1 |
Zaloguj się do Control Hub i przejdź do Po wiad omienia > Moje reguły. |
| 2 |
Na karcie Wszystkie reguły wybierz regułę. |
| 3 |
W sekcji Metoda dostawy zaznacz pole wyboru Webhook. W zależności od rodzaju tworzonego alertu wyświetlany jest przykład ładunku, dzięki czemu możesz wiedzieć, czego się spodziewać. 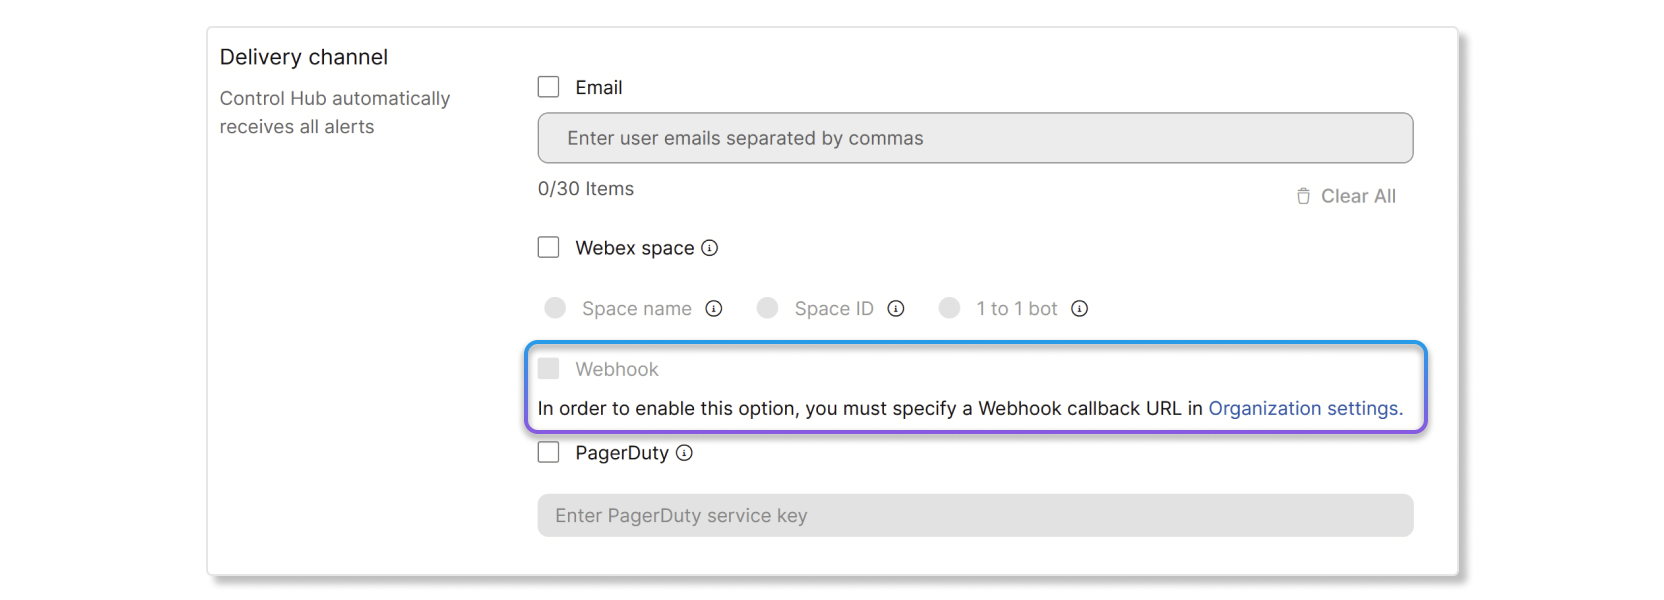
|
| 4 |
Kliknij przycisk Zapisz. |
Odniesienie do pola webhook urządzeń Cisco
Aby uzyskać informacje na temat odniesień do pól webhook dla urządzeń Cisco, zobacz ten artykuł.
Możesz skonfigurować klucz integracji PageDuty, aby alerty pojawiały się w aplikacjach innych firm.
Włącz PagerDuty w regułach
Zanim zaczniesz
Najpierw musisz uzyskać klucz integracji w PagerDuty, zanim będzie można włączyć ustawienie PagerDuty dla alertów w Control Hub. Aby uzyskać klucz integracyjny, utwórz nową usługę w PagerDuty i wybierz Events API V2 jako integrację. Po utworzeniu usługi Events API V2 klucz integracji można znaleźć w zakładce Integracje na pulpicie PageDuty .
| 1 |
Zaloguj się do Control Hub i przejdź do Po wiad omienia > Moje reguły. |
| 2 |
W sekcji Kanał dostawy zaz nacz pole wyboru PageDuty. |
| 3 |
Wprowadź klucz integracji utworzony w panelu PagerDuty. |
| 4 |
Kliknij przycisk Zapisz. |


